
Кластеризация семантики в эпоху нейросетей: новое против проверенных методов
Расшифровка доклада на конференции Optimization 2025. Номера слайдов соответствуют презентации.
Сегодня для кластеризации семантики есть четыре подхода: классическая кластеризация по ТОПу с вариациями (по Яндексу, по Google, по сайту-лидеру вроде OZON или banki.ru), кластеризация по эмбеддингам — векторным представлениям фраз, кластеризация через LLM и группировка по данным Яндекс.Вебмастера. Задача доклада — сравнить их на реальных ядрах и понять, что работает.
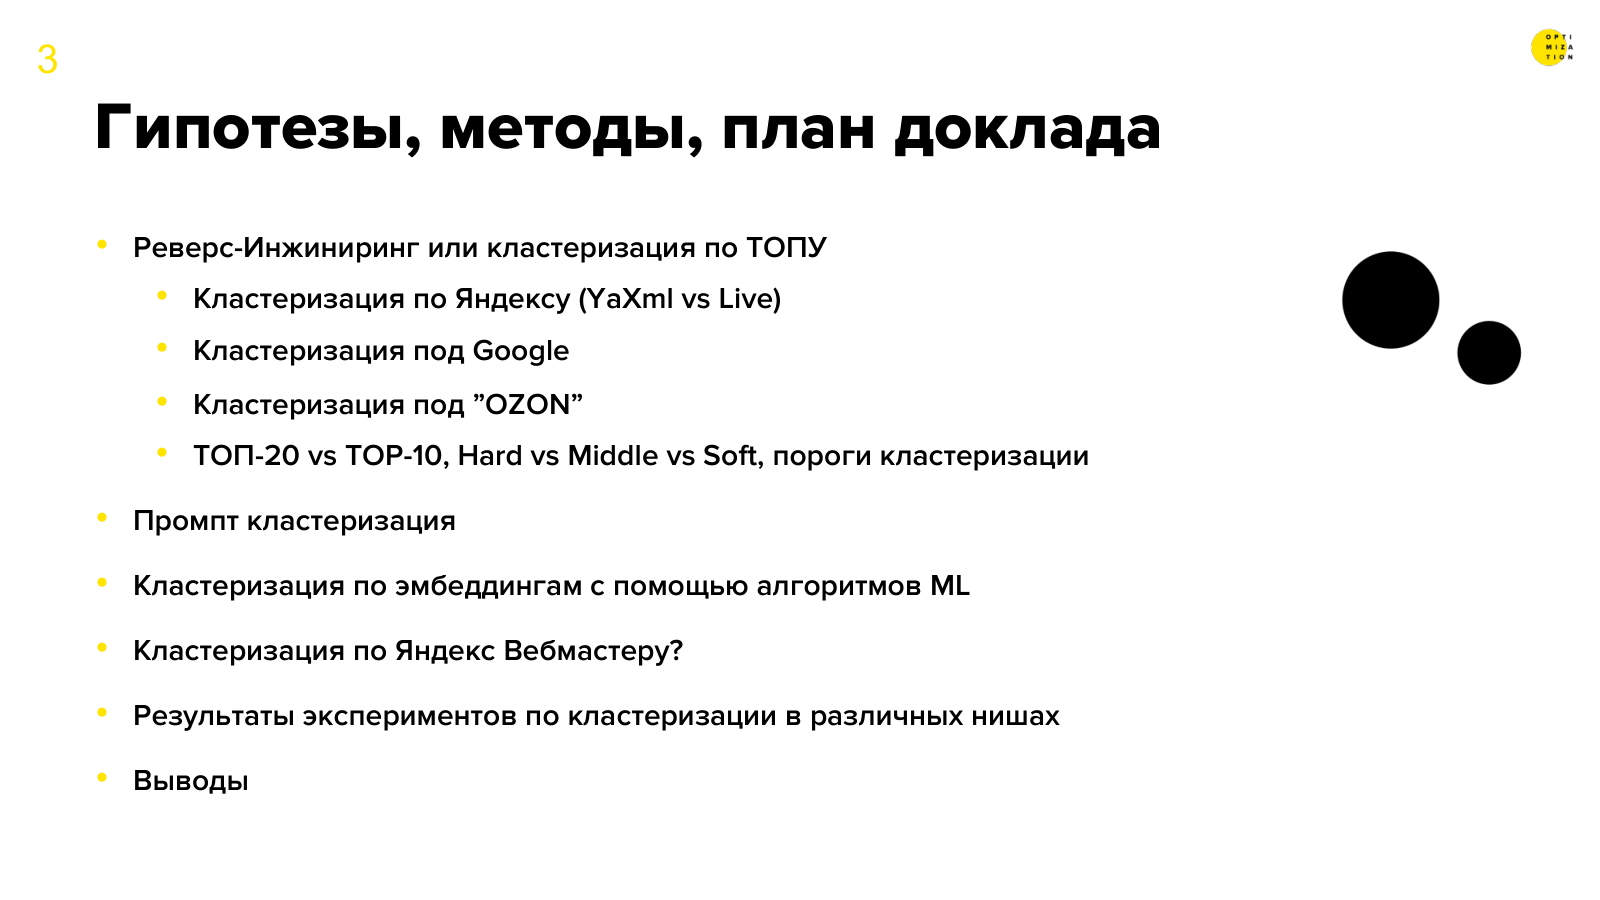 Слайд 3 — гипотезы, методы, план доклада
Методика: как вообще оценивать кластеризацию
Основная проблема
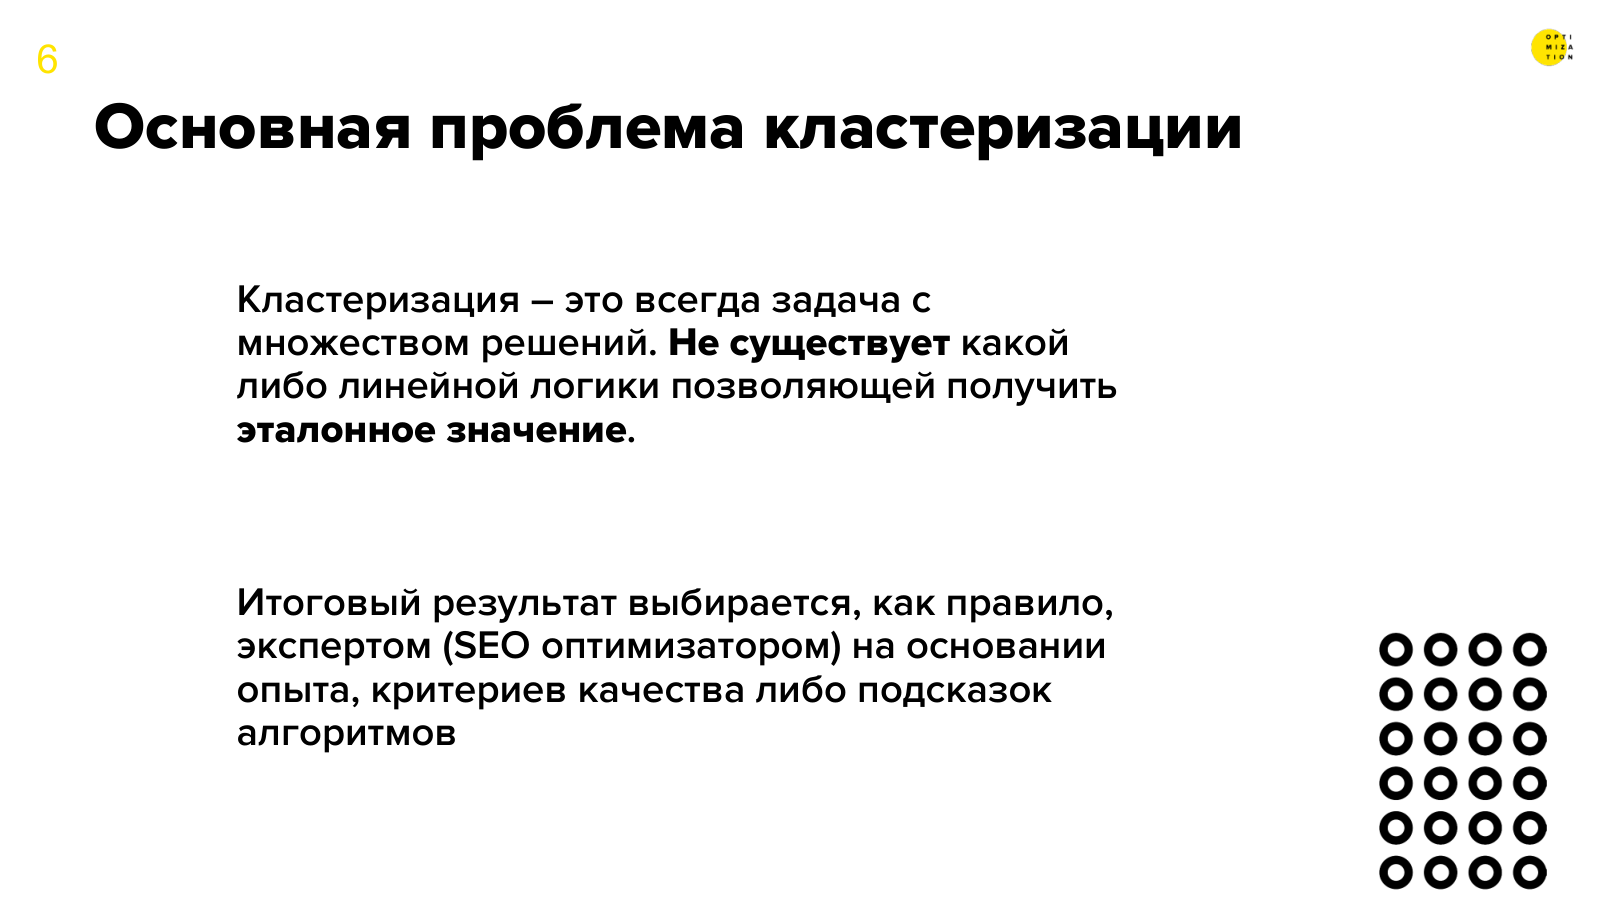 Слайд 5 — основная проблема кластеризации
Есть список запросов, сеошник разбил его на кластеры. Первый вопрос — правильно разбил или нет? На практике оценка выглядит так: специалист смотрит на ядро и говорит «здесь что-то не то, пересоберите».
Отсюда первый постулат: кластеризация — это всегда задача с множеством решений. Не существует линейной логики, позволяющей получить эталонное значение, — как в уравнении x + y = 10. Нет единственного идеального метода, и итоговый результат выбирает эксперт на основании опыта, критериев качества либо подсказок алгоритмов.
Вопрос в том, можно ли натянуть на эту задачу алгоритмы машинного обучения.
Два типа оценки
 Слайд 6 — методы оценки результата
Внешние меры основаны на сравнении результата кластеризации с эталонной выборкой. Эталон берётся у эксперта, который давно работает в нише. Для эксперимента такие ядра предоставили коллеги — запрос на сбор эталонов публиковался в телеграм-канале, ядра собраны руками и размечены по кластерам.
Внутренние меры отображают качество кластеризации только по информации в самих данных, без эталона.
Метрика ARI
 Слайд 8 — внешняя метрика ARI
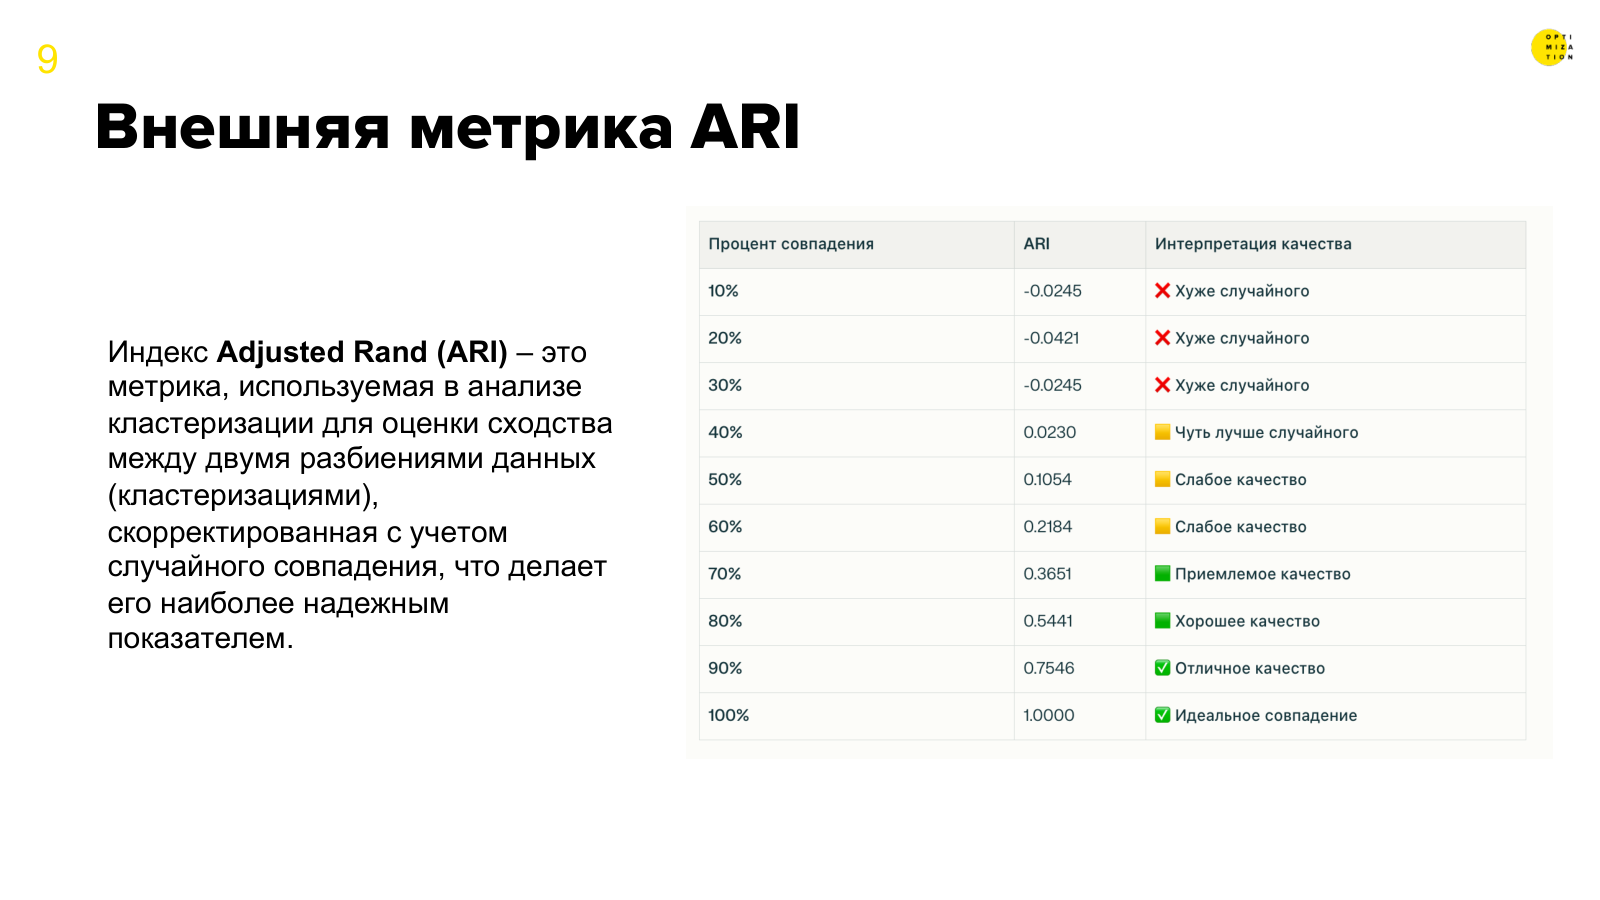
Основная метрика сравнения — Adjusted Rand Index (ARI). Это метрика сходства двух разбиений данных, скорректированная с учётом случайного совпадения, что делает её наиболее надёжным показателем. Внешних метрик в литературе пара десятков, ARI выбрана после перебора как дающая наиболее адекватные значения.
Пороги, которые используются дальше на всех графиках: ARI ≥ 0,6 — хорошо, ARI ≥ 0,3 — приемлемо. Дополнительно фиксировалась метрика Purity.
Проблема внутренних метрик
 Слайд 10 — эмпирический метод подбора весовых коэффициентов
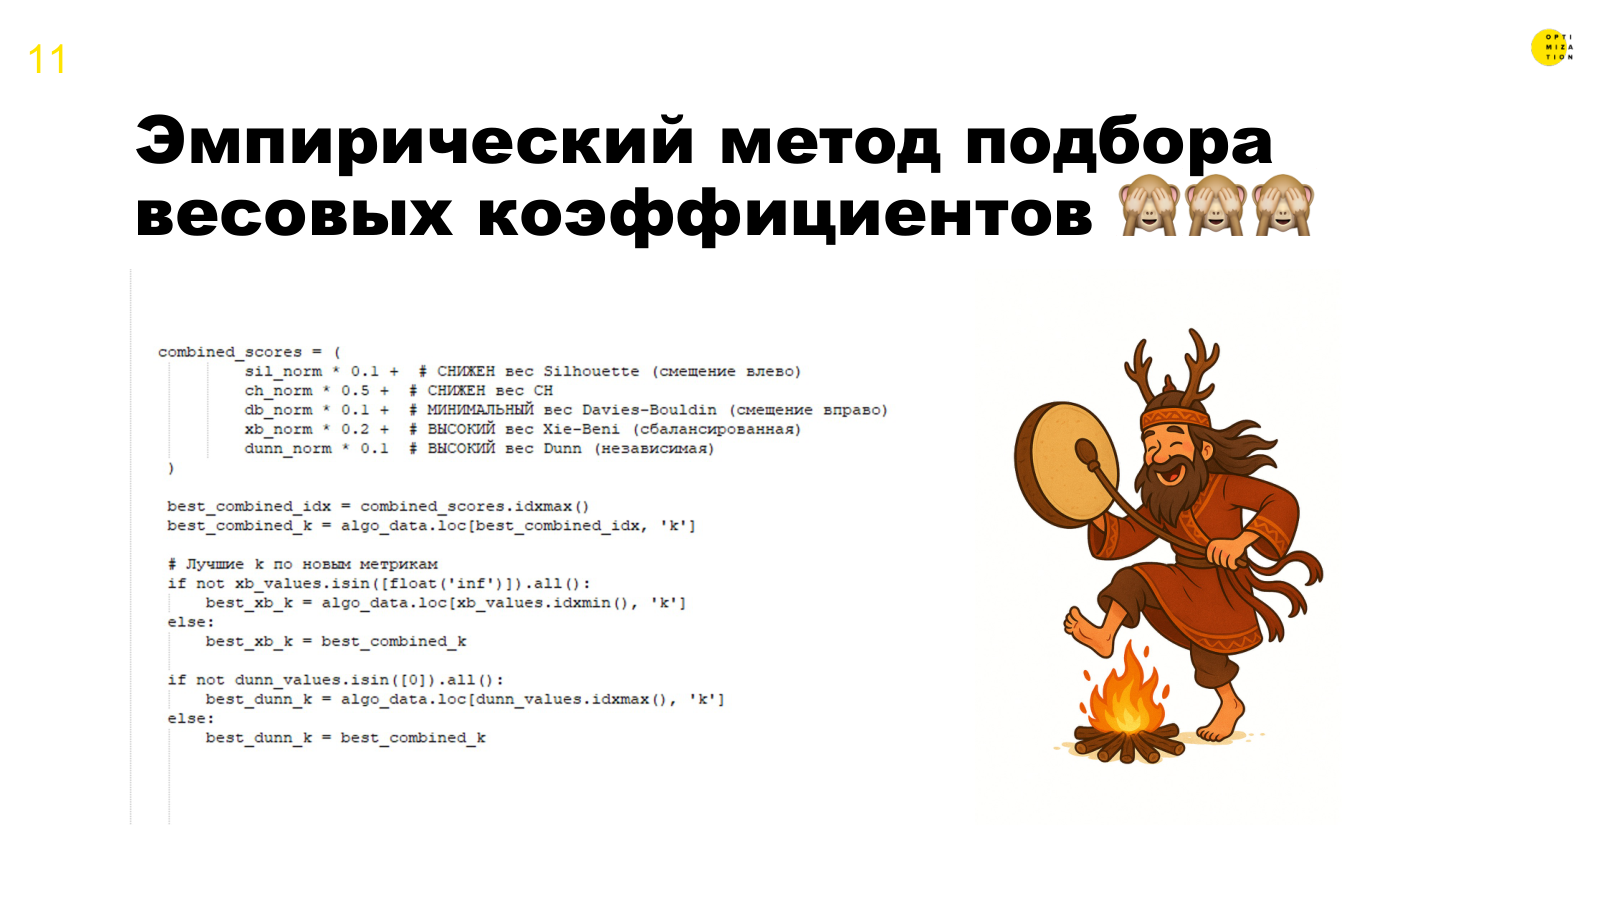
Внутренних метрик тоже десятки, и возникает соблазн скомбинировать их все, навесив весовые коэффициенты, чтобы получить единый показатель качества. Формально это называется «эмпирический метод подбора весовых коэффициентов для различных математических моделей». По факту — подгон под результат, и это главная слабость всей внутренней оценки.
Причина в том, что метрики систематически смещены. На ядре, где по эталону должно быть около 100 кластеров, одна метрика считает оптимумом 10 кластеров, другая — 400, третья держится середины. В эксперименте метрики были разделены на группы по направлению смещения и сведены с весами, но честно называть такой показатель объективным нельзя.
Метод 1. Кластеризация по ТОПу
 Слайд 12 — порядок действий, вариации и критика метода
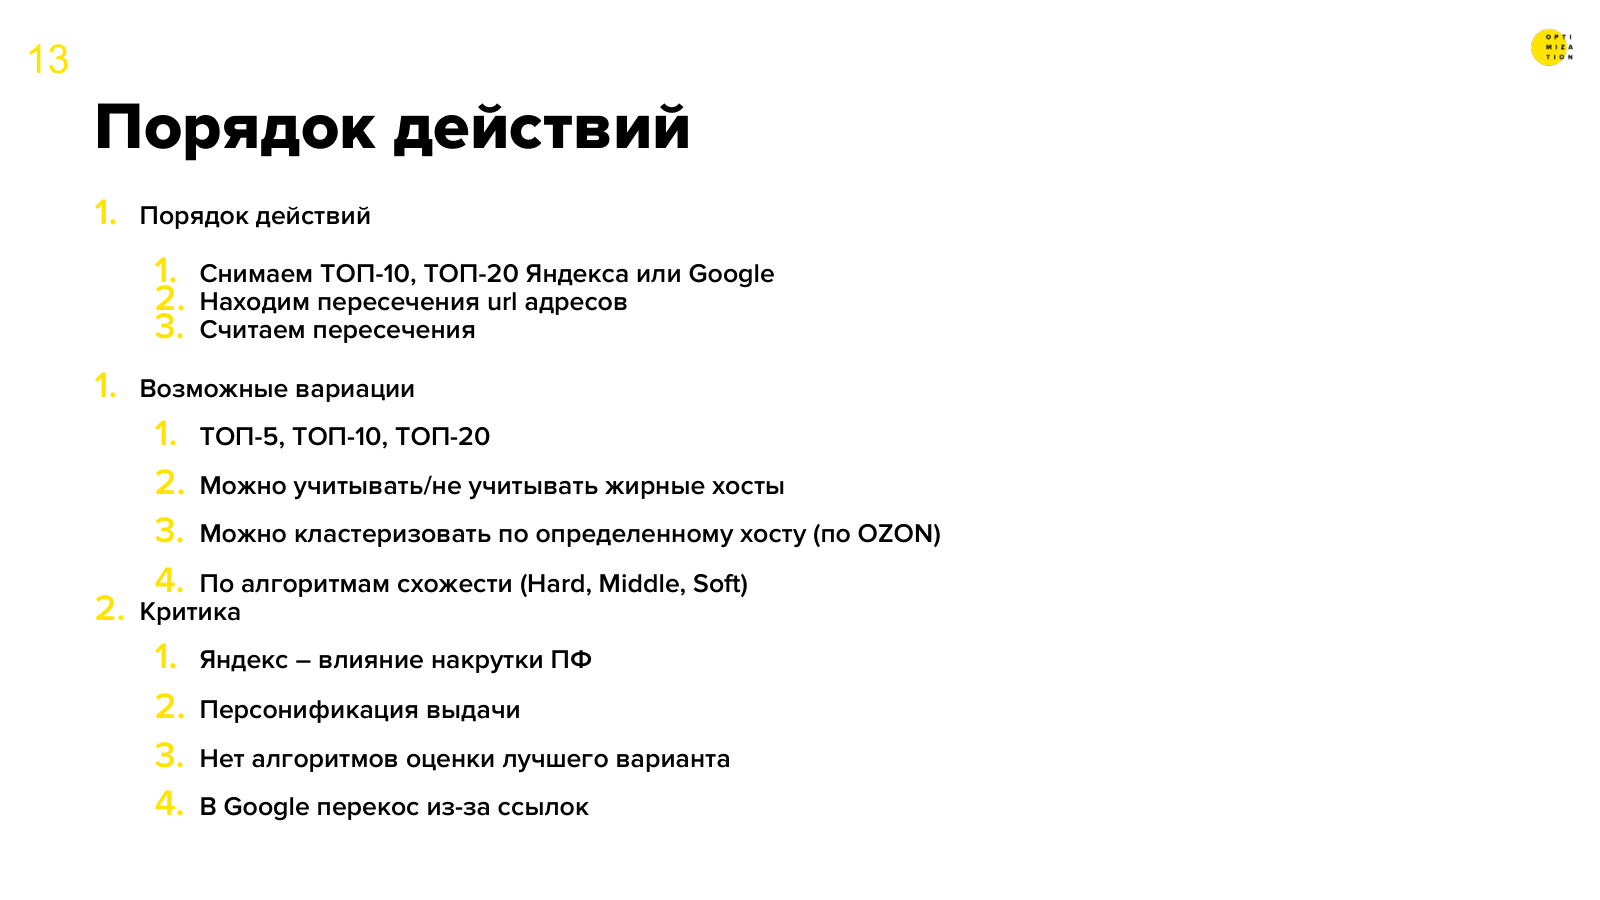
Порядок действий:
- Снимаем ТОП-10 или ТОП-20 Яндекса либо Google.
- Находим пересечения URL-адресов.
- Считаем пересечения.
Возможные вариации: глубина ТОП-5, ТОП-10, ТОП-20; учитывать или не учитывать жирные хосты; кластеризовать по определённому хосту (по OZON, Exist.ru, banki.ru, sravni.ru); менять алгоритм схожести — hard, middle, soft.
Критика метода:
- Яндекс — влияние накрутки ПФ. В конкурентных нишах выдача перекручена: если у сайта хорошие поведенческие, к нему автоматически подтягиваются дополнительные запросы, и семантика вслед за этим искажается.
- Персонификация выдачи.
- Нет алгоритмов оценки лучшего варианта.
- В Google перекос из-за ссылок.
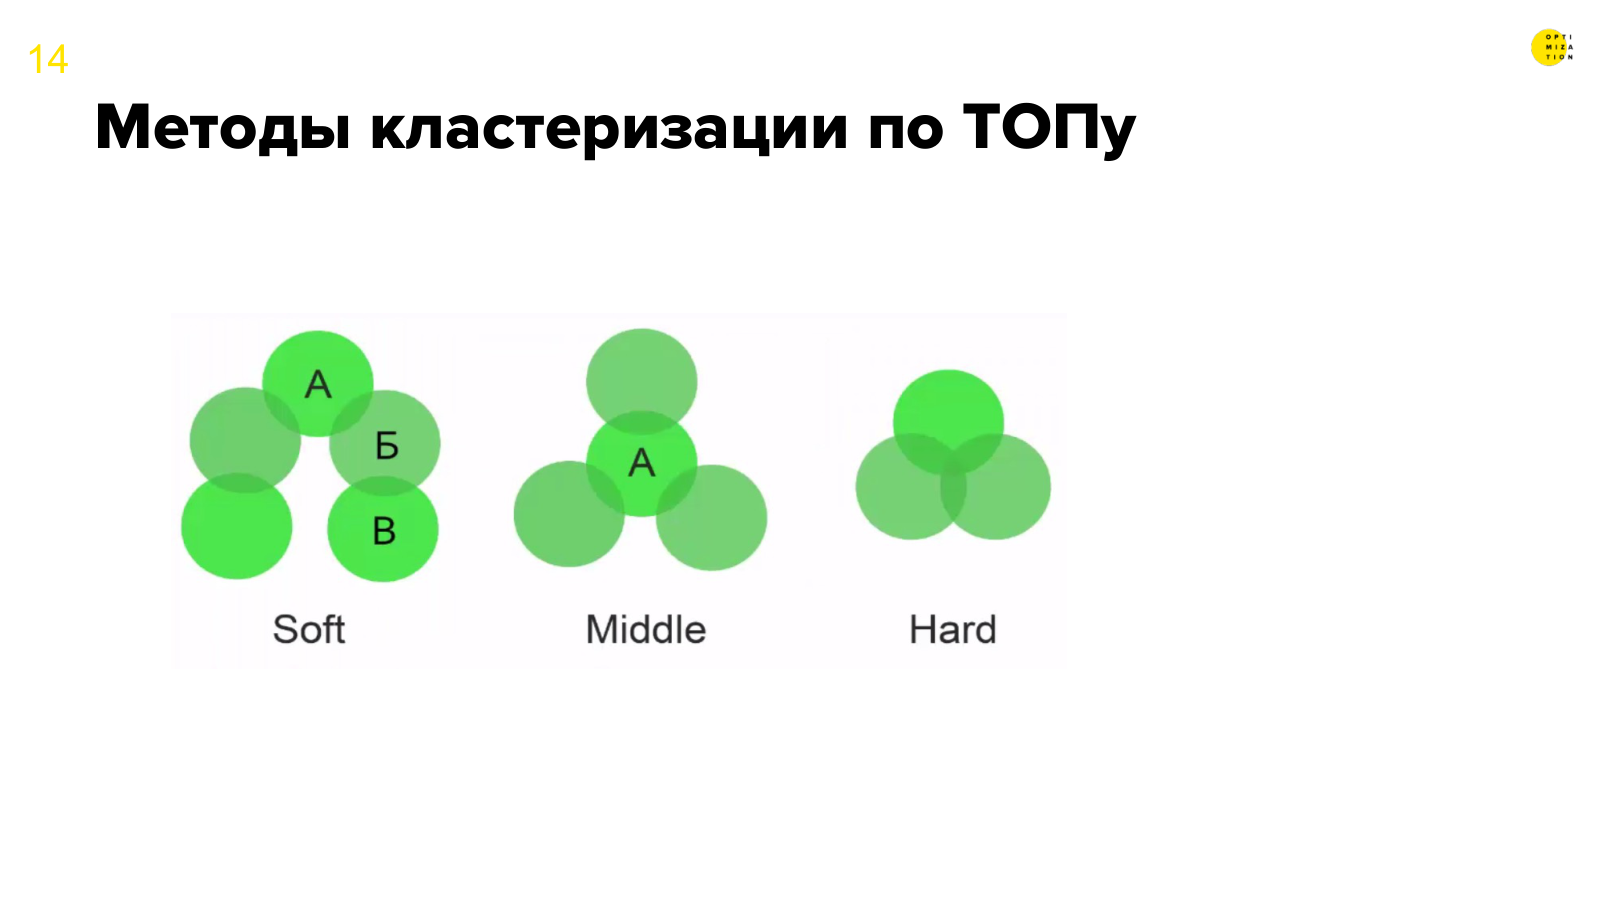 Слайд 13 — soft, middle и hard
Разница между порогами: при soft достаточно цепочки связей (А связан с Б, Б с В), при middle все запросы должны быть связаны с центральным, при hard — связаны попарно между собой.
Метод 2. Кластеризация по эмбеддингам
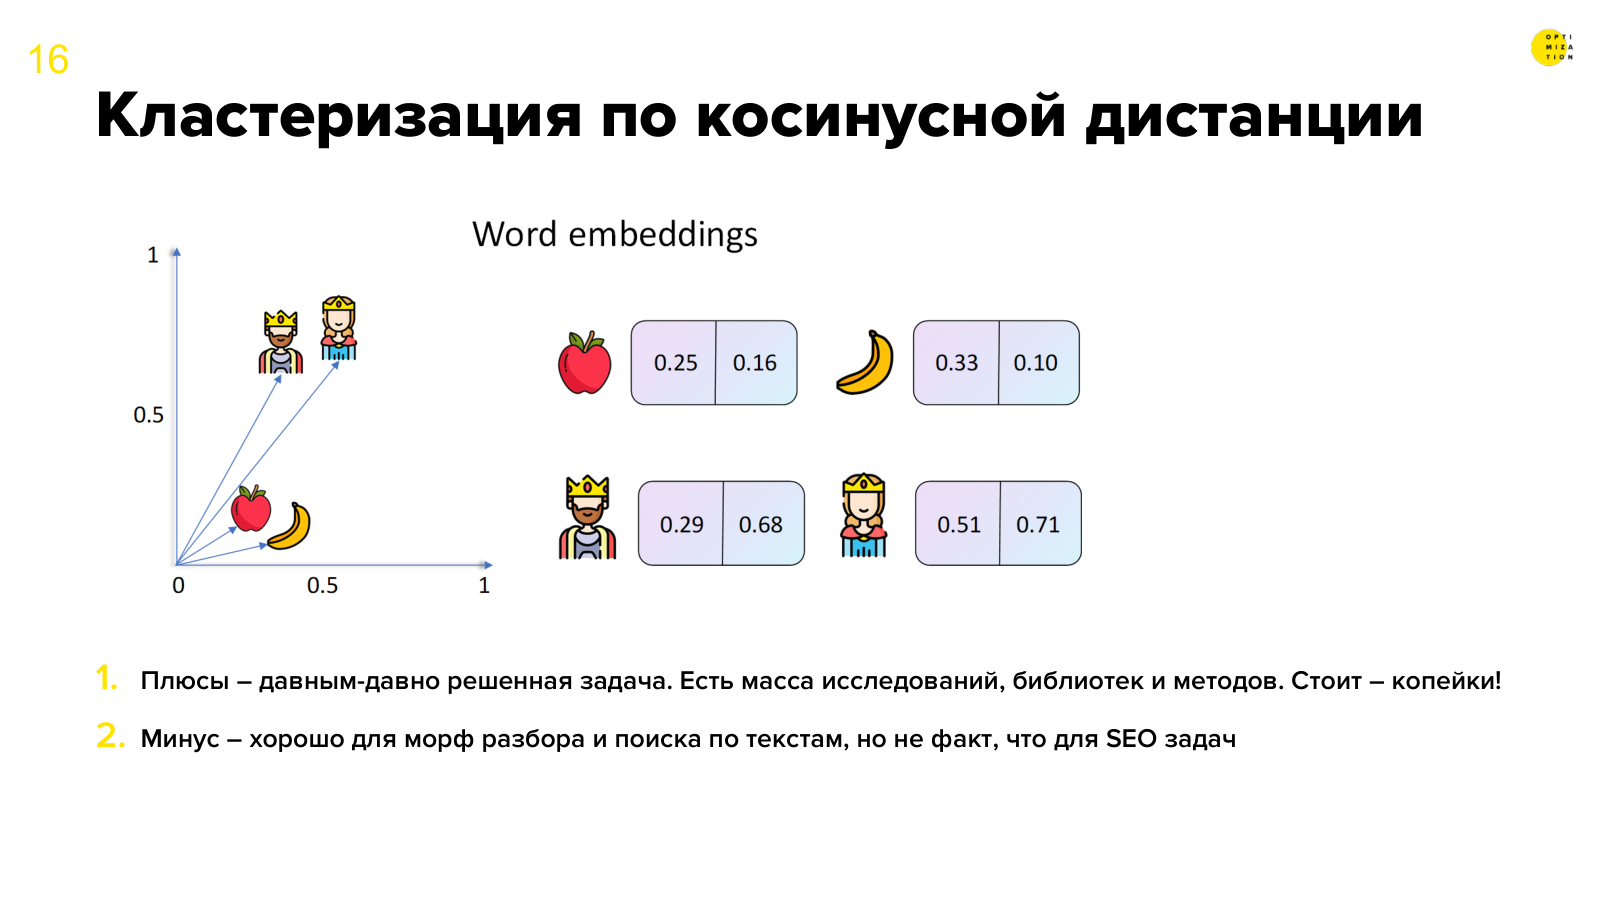 Слайд 15 — кластеризация по косинусной дистанции
Любая LLM представляет фразу — именно фразу, а не отдельное слово — в виде вектора. Близкие по смыслу фразы оказываются рядом в векторном пространстве: «прожектор», «объектив», «камера», «фоторепортёр» соберутся в одной области. На этом принципе построены поиск по векторным базам и RAG.
Плюс — давно решённая задача, есть масса исследований, библиотек и методов, стоит копейки. Минус — метод хорошо показывает себя в морфологическом разборе и поиске по текстам, но не факт, что подходит для SEO-задач.
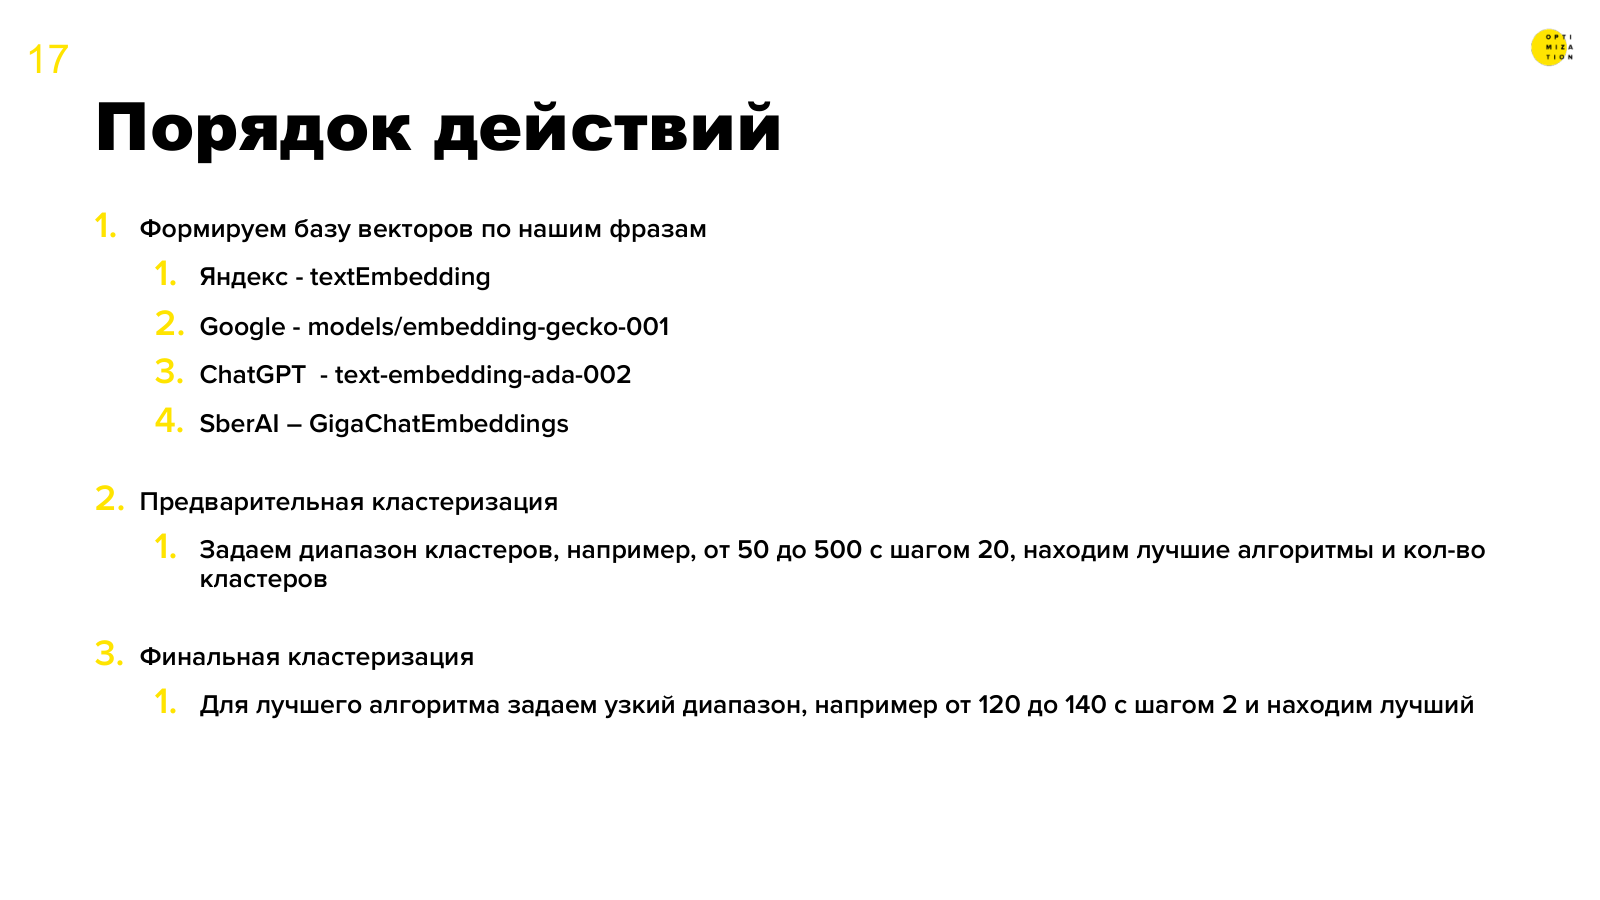 Слайд 16 — порядок действий
- Формируем базу векторов по своим фразам. Варианты моделей: Яндекс textEmbedding, Google
models/embedding-gecko-001, OpenAItext-embedding-ada-002, GigaChat Embeddings от SberAI. В экспериментах использовалась модель Яндекса — она быстрая, базу можно собрать оперативно. - Предварительная кластеризация. Задаём широкий диапазон, например от 50 до 500 кластеров с шагом 20, находим лучшие алгоритмы и количество кластеров.
- Финальная кластеризация. Для лучшего алгоритма берём узкий диапазон, например от 120 до 140 с шагом 2.
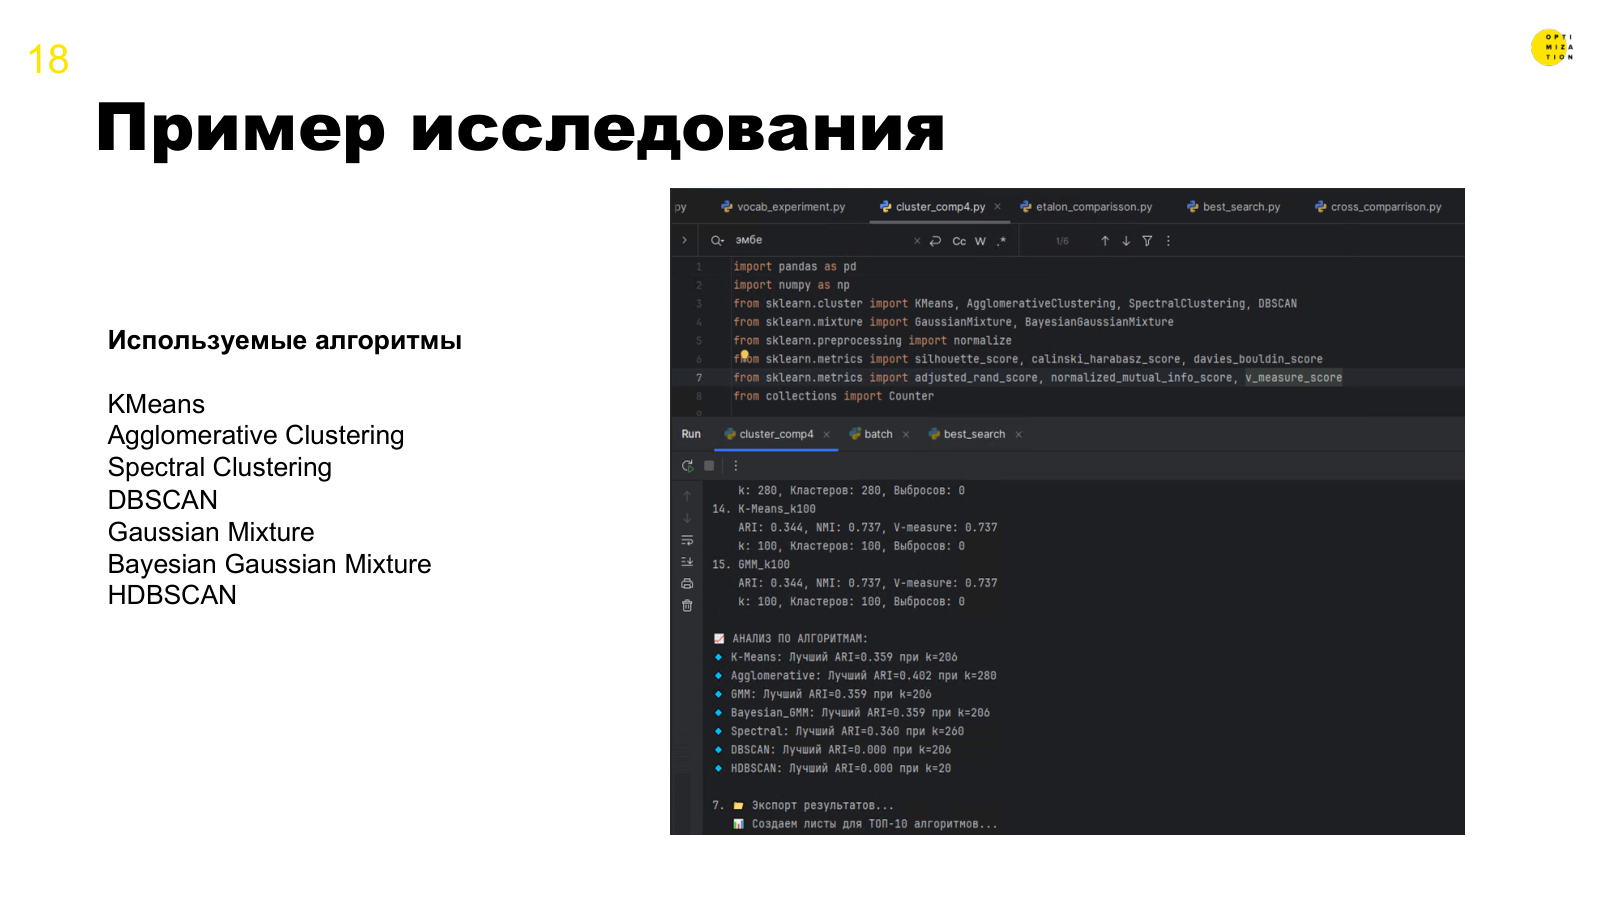 Слайд 17 — используемые алгоритмы и пример расчёта
Использованные алгоритмы: KMeans, Agglomerative Clustering, Spectral Clustering, DBSCAN, Gaussian Mixture, Bayesian Gaussian Mixture, HDBSCAN.
На прогоне видно типичную картину: Agglomerative — лучший ARI 0,402 при k = 280, Spectral — 0,360 при k = 260, K-Means, GMM и Bayesian GMM — 0,359 при k = 206, а DBSCAN и HDBSCAN дают 0,000, то есть на такой семантике неприменимы.
Метод 3. Кластеризация через LLM
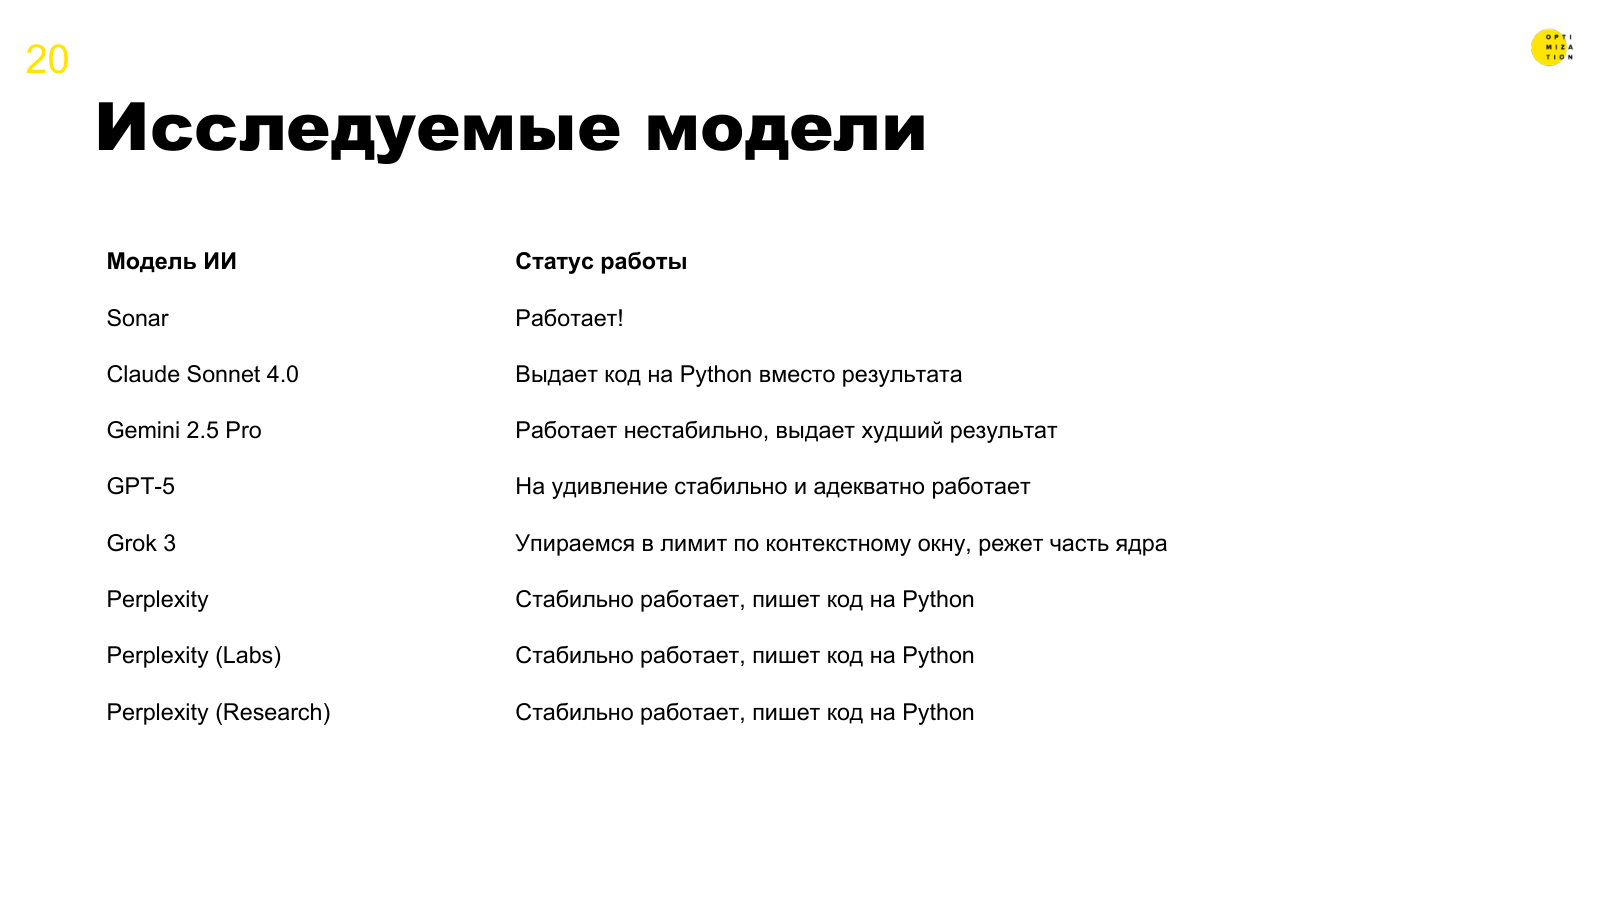 Слайд 19 — исследуемые модели и статус работы
Ядро передаётся модели с задачей раскидать запросы по семантической близости.
| Модель | Статус работы |
|---|---|
| GPT-5 | На удивление стабильно и адекватно работает |
| Sonar | Работает |
| Perplexity | Стабильно работает, пишет код на Python |
| Perplexity (Labs) | Стабильно работает, пишет код на Python |
| Perplexity (Research) | Стабильно работает, пишет код на Python |
| Gemini 2.5 Pro | Работает нестабильно, выдаёт худший результат |
| Claude Sonnet 4.0 | Выдаёт код на Python вместо результата |
| Grok 3 | Упирается в лимит контекстного окна, режет часть ядра |
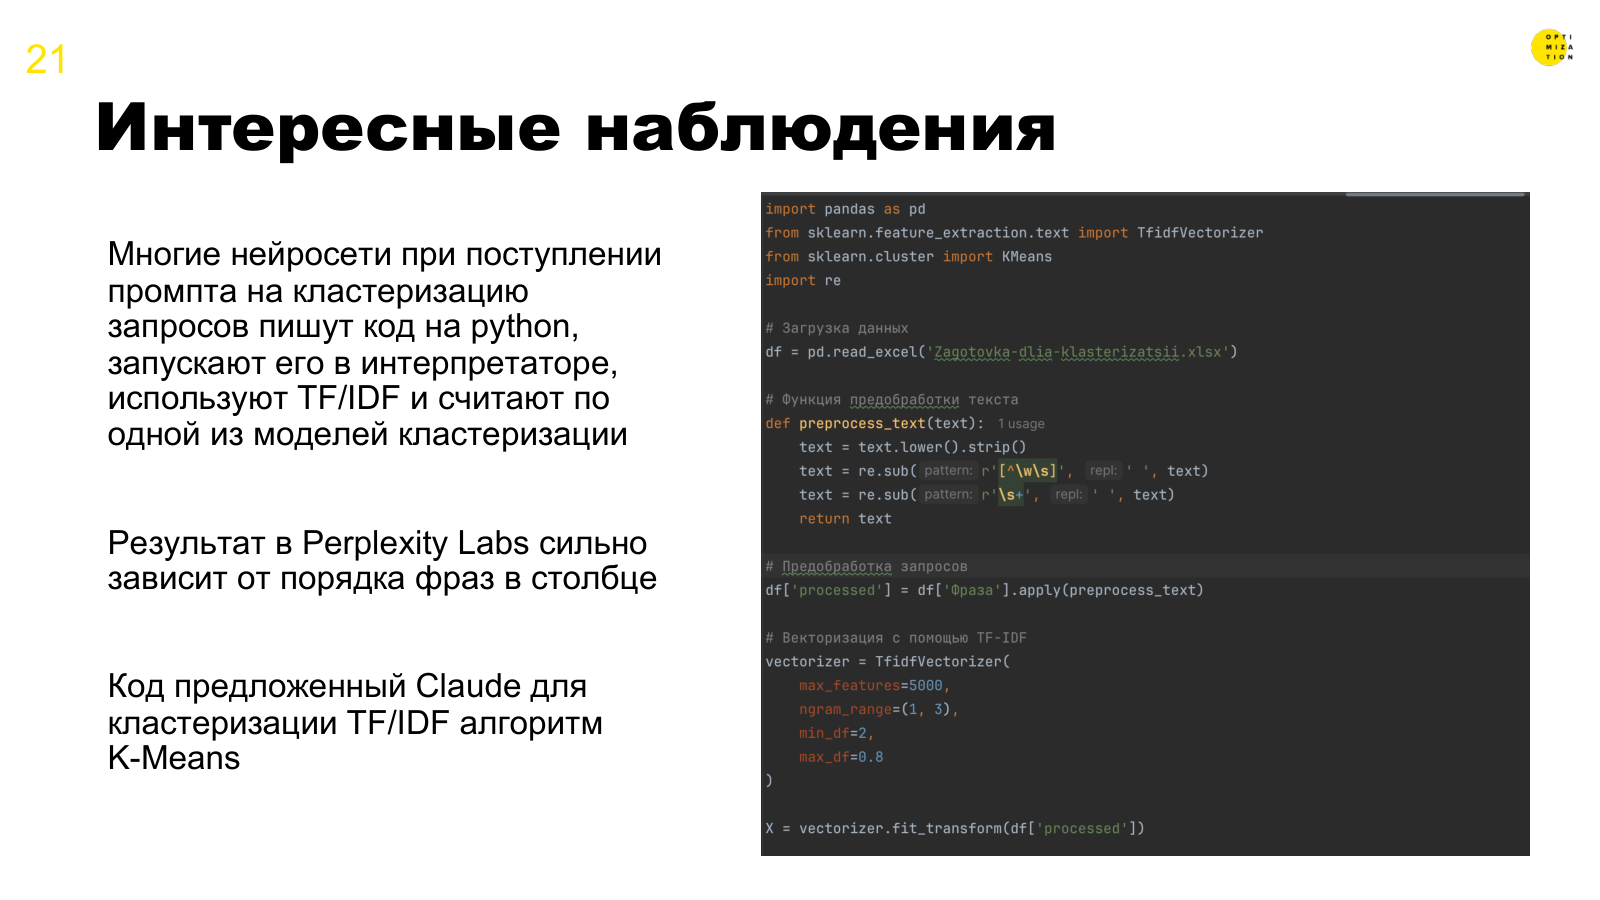 Слайд 20 — интересные наблюдения
Многие нейросети не кластеризуют, а пишут код. Получив промпт на кластеризацию запросов, модель генерирует Python-скрипт, запускает его в интерпретаторе, считает TF-IDF и применяет одну из классических моделей кластеризации. Код, предложенный Claude, — это TF-IDF плюс K-Means. То есть под видом нейросетевой кластеризации пользователь получает обычную статистику.
Результат зависит от порядка фраз в столбце. У Perplexity Labs это проявилось наглядно: при подаче уже сгруппированного ядра, где просто убран столбец с номером кластера, модель почти восстанавливает исходную разметку и результат выглядит блестяще. Если тот же список перемешать — результат резко ухудшается. Наблюдение подсказал Андрей Буйлов.
Эксперимент 1. Займы — сложные высококонкурентные услуги
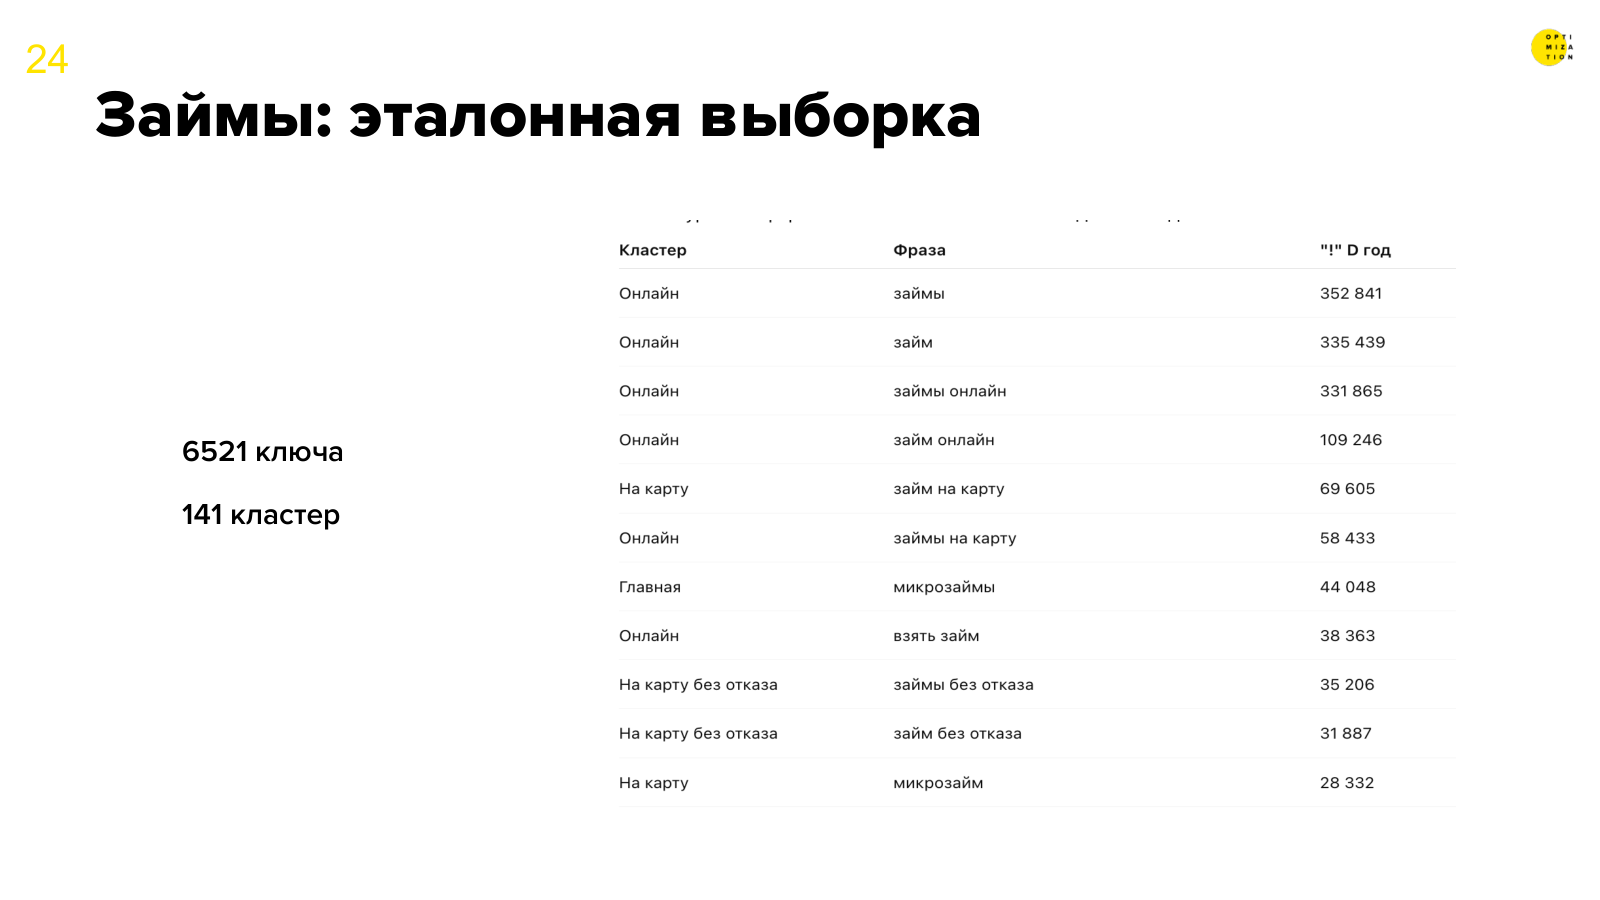 Слайд 23 — эталонная выборка: 6521 ключ, 141 кластер
Лучшие результаты:
| Метод | ARI | Purity | Статус |
|---|---|---|---|
| Яндекс XML, по sravni.ru, middle 6 | 0,502 | 0,719 | Хорошо |
| Яндекс XML, по sravni.ru, 3 | 0,501 | 0,717 | Хорошо |
| Яндекс XML, middle 6 | 0,475 | 0,706 | Хорошо |
| Эмбеддинги, агломеративная, k = 380 | 0,418 | 0,703 | Хорошо |
| Google, по sravni.ru, middle 6 | 0,413 | 0,761 | Хорошо |
| Эмбеддинги, агломеративная, k = 160 | 0,405 | 0,584 | Удовлетворительно |
| Эмбеддинги, агломеративная, k = 140 | 0,394 | 0,571 | Удовлетворительно |
| LLM, Perplexity (с подбором промпта) | 0,389 | 0,607 | Удовлетворительно |
Лучшие результаты дала кластеризация по сайту-лидеру ниши, middle-пороги по ТОП-20 Яндекса и агломеративная кластеризация по эмбеддингам.
Худшие результаты:
| Метод | ARI | Purity |
|---|---|---|
| Яндекс Live, 4 | 0,109 | 0,790 |
| Эмбеддинги, спектральная, k = 100 | 0,098 | 0,507 |
| LLM, Perplexity Labs | 0,097 | 0,454 |
| LLM, Grok 3 | 0,091 | 0,358 |
| Эмбеддинги, спектральная, k = 140 | 0,082 | 0,506 |
| ТОП-10 Яндекс XML, 4 | 0,074 | 0,805 |
| ТОП-10 Яндекс XML, 4, soft | 0,060 | 0,340 |
| LLM, Claude Sonnet | 0,027 | 0,571 |
| Эмбеддинги, GMM, k = 380 | 0,023 | 0,692 |
| LLM, Sonar | 0,007 | 0,731 |
| LLM, Gemini 2.5 | −0,012 | 0,280 |
Ключевое наблюдение: чем жёстче ограничения, тем хуже результат. Кластеризация по ТОП-10 с высоким порогом совпадений провалилась. Все LLM получили неуд, Gemini 2.5 — отрицательный ARI, то есть разбиение хуже случайного.
Google и Яндекс на этом ядре показали сопоставимые результаты.
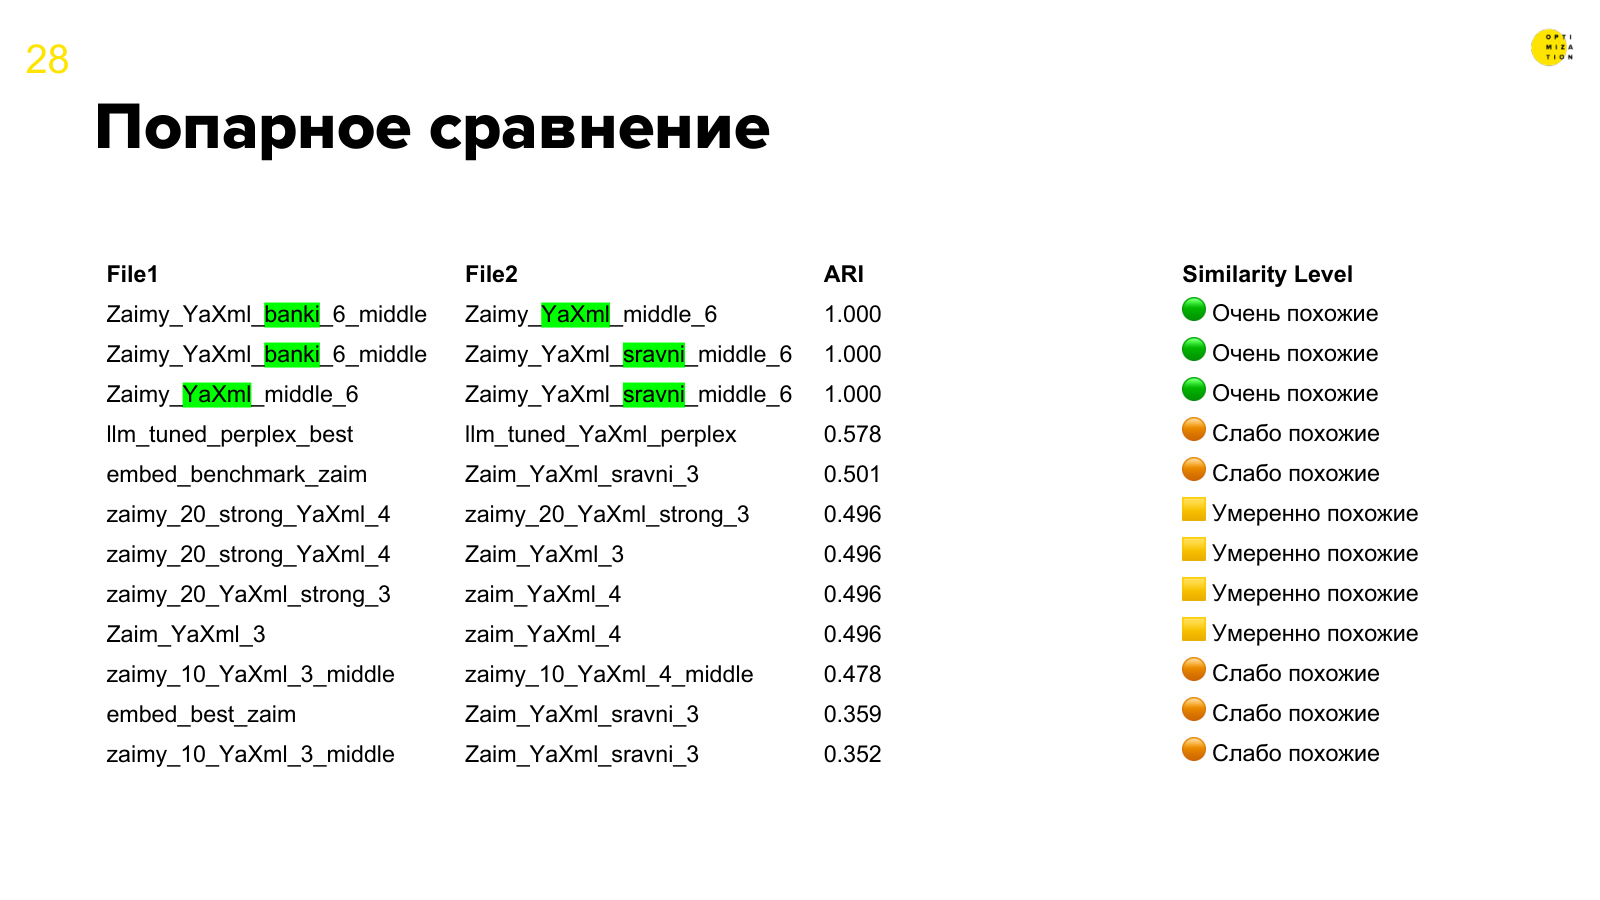 Слайд 27 — попарное сравнение методов между собой
Отдельно считалось, насколько методы похожи друг на друга, а не на эталон. Кластеризации по Яндекс XML — по banki.ru, по sravni.ru и middle 6 — дают ARI 1,000 между собой, то есть фактически один и тот же результат. А вот эмбеддинги и ТОП дают слабое сходство (около 0,35–0,50): это разные разбиения, а не варианты одного.
Эксперимент 2. Автозапчасти — простая категорийка
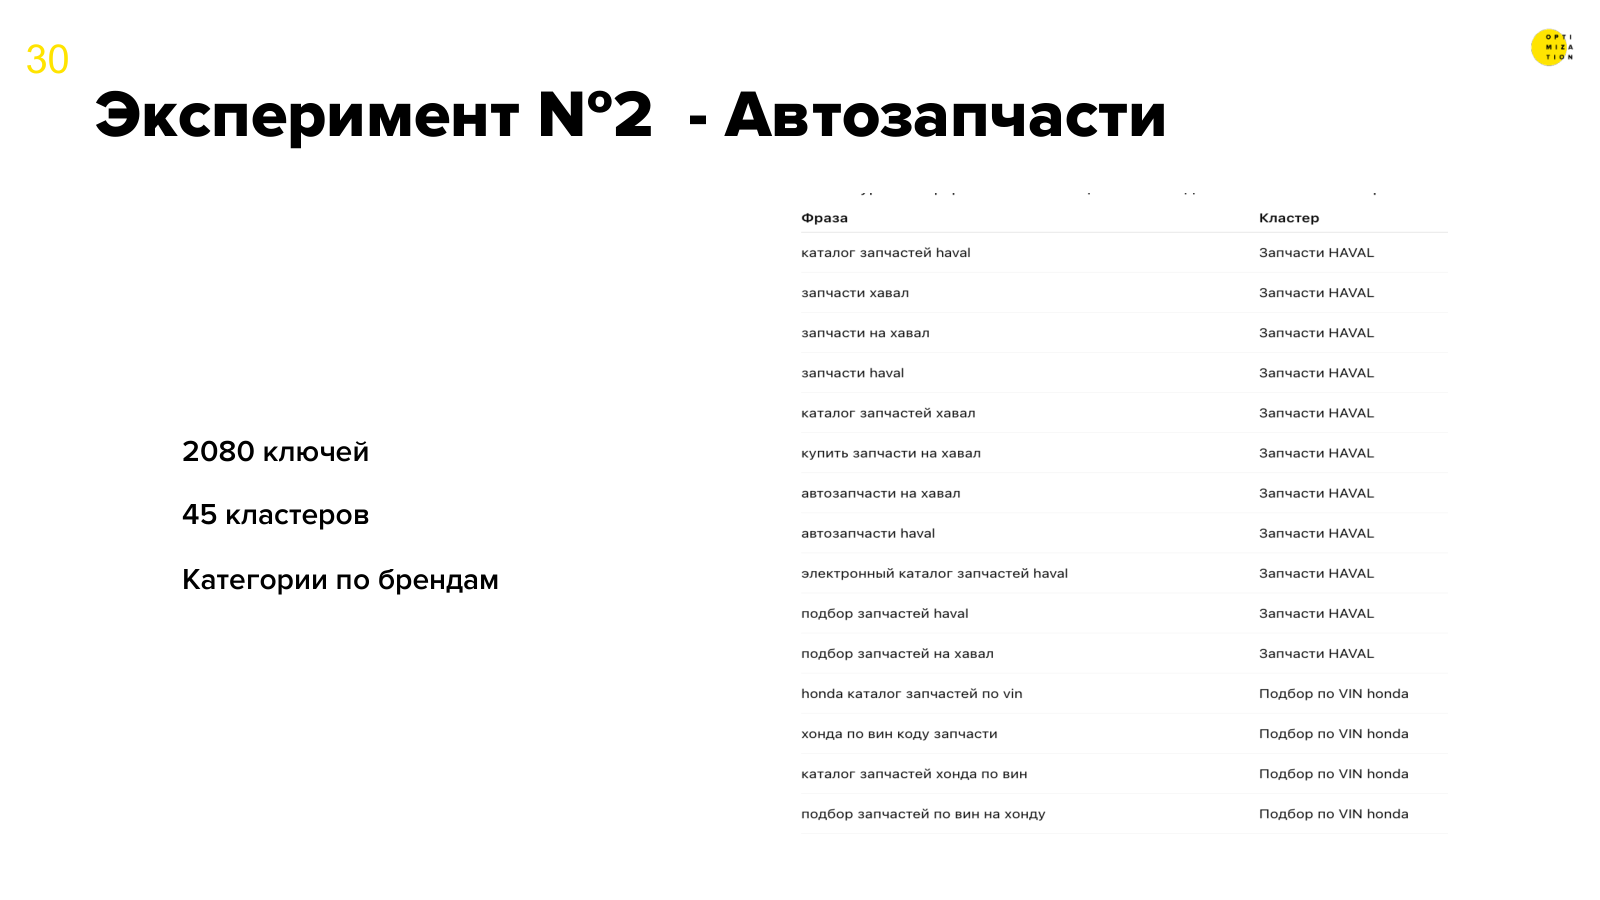 Слайд 29 — 2080 ключей, 45 кластеров, категории по брендам
Ядро однородное: «запчасти Haval» в разных написаниях и аналогичные запросы по брендам.
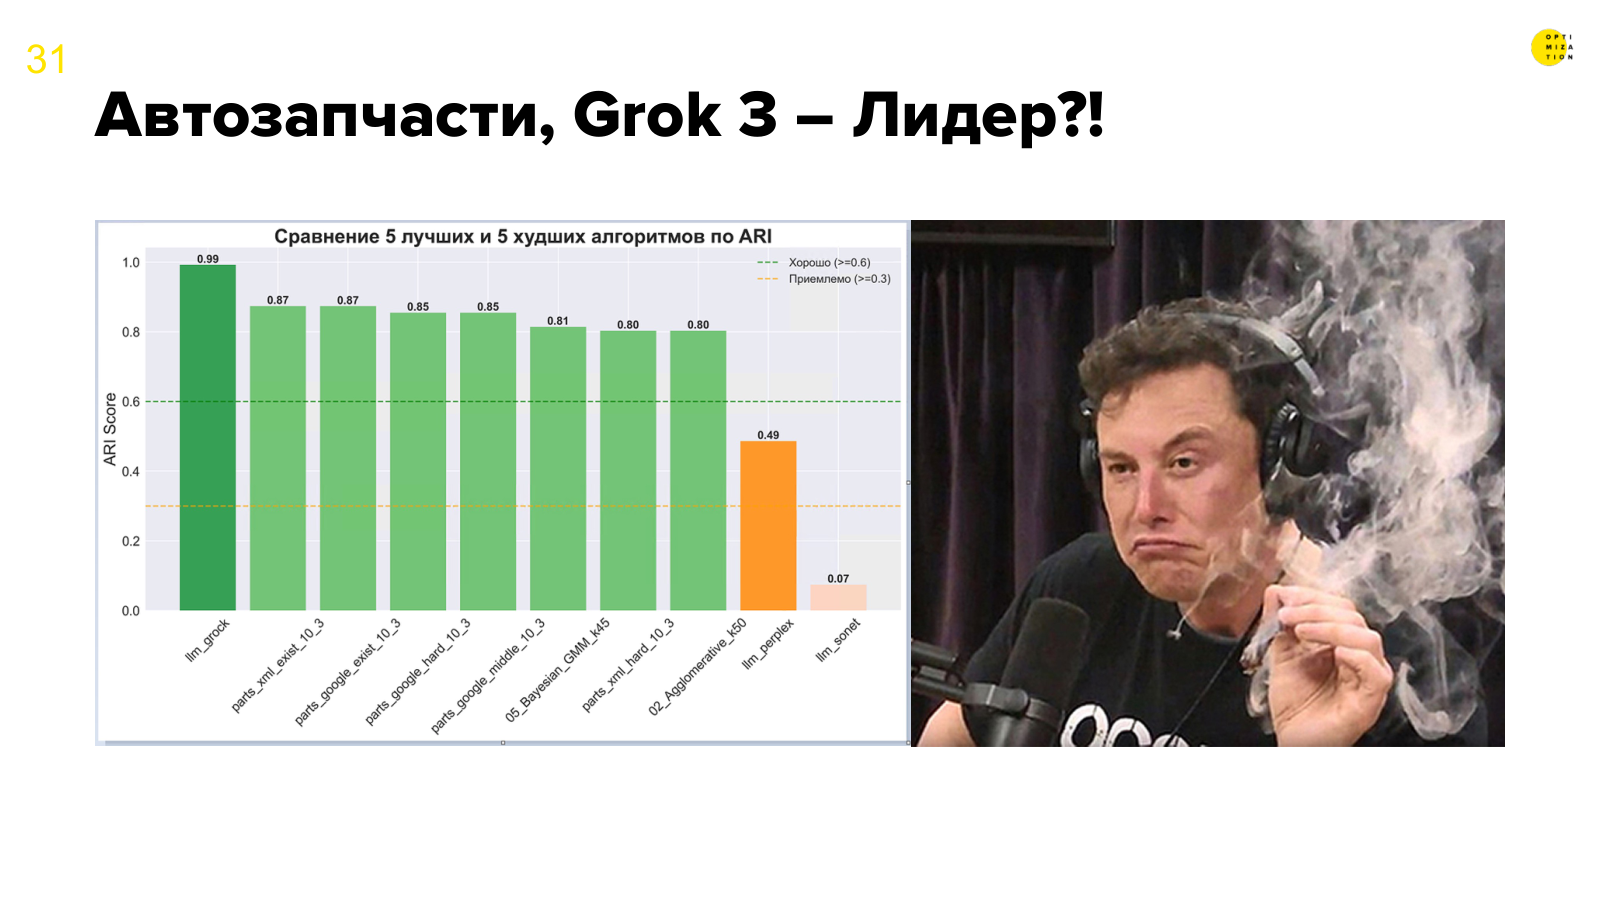 Слайд 30 — сравнение 5 лучших и 5 худших алгоритмов по ARI
| Метод | ARI |
|---|---|
| LLM, Grok 3 | 0,99 |
| Яндекс XML, по Exist.ru, 10_3 | 0,87 |
| Google, по Exist.ru, 10_3 | 0,87 |
| Google, hard, 10_3 | 0,85 |
| Google, middle, 10_3 | 0,85 |
| Эмбеддинги, Bayesian GMM, k = 45 | 0,81 |
| Яндекс XML, hard, 10_3 | 0,80 |
| Эмбеддинги, агломеративная, k = 50 | 0,80 |
| LLM, Perplexity | 0,49 |
| LLM, Claude Sonnet | 0,07 |
Grok 3 — почти полное совпадение с эталоном, при том что на больших ядрах эта же модель режет данные из-за контекстного окна. На простой однородной семантике LLM внезапно оказывается лучшим методом.
Эмбеддинги здесь тоже отработали на уровне ТОПа. Практический вывод: на гигантских ядрах, где снятие выдачи слишком дорого и долго, эмбеддинги дают сопоставимый результат намного дешевле.
Эксперимент 3. Детские коляски — категорийка с тегами
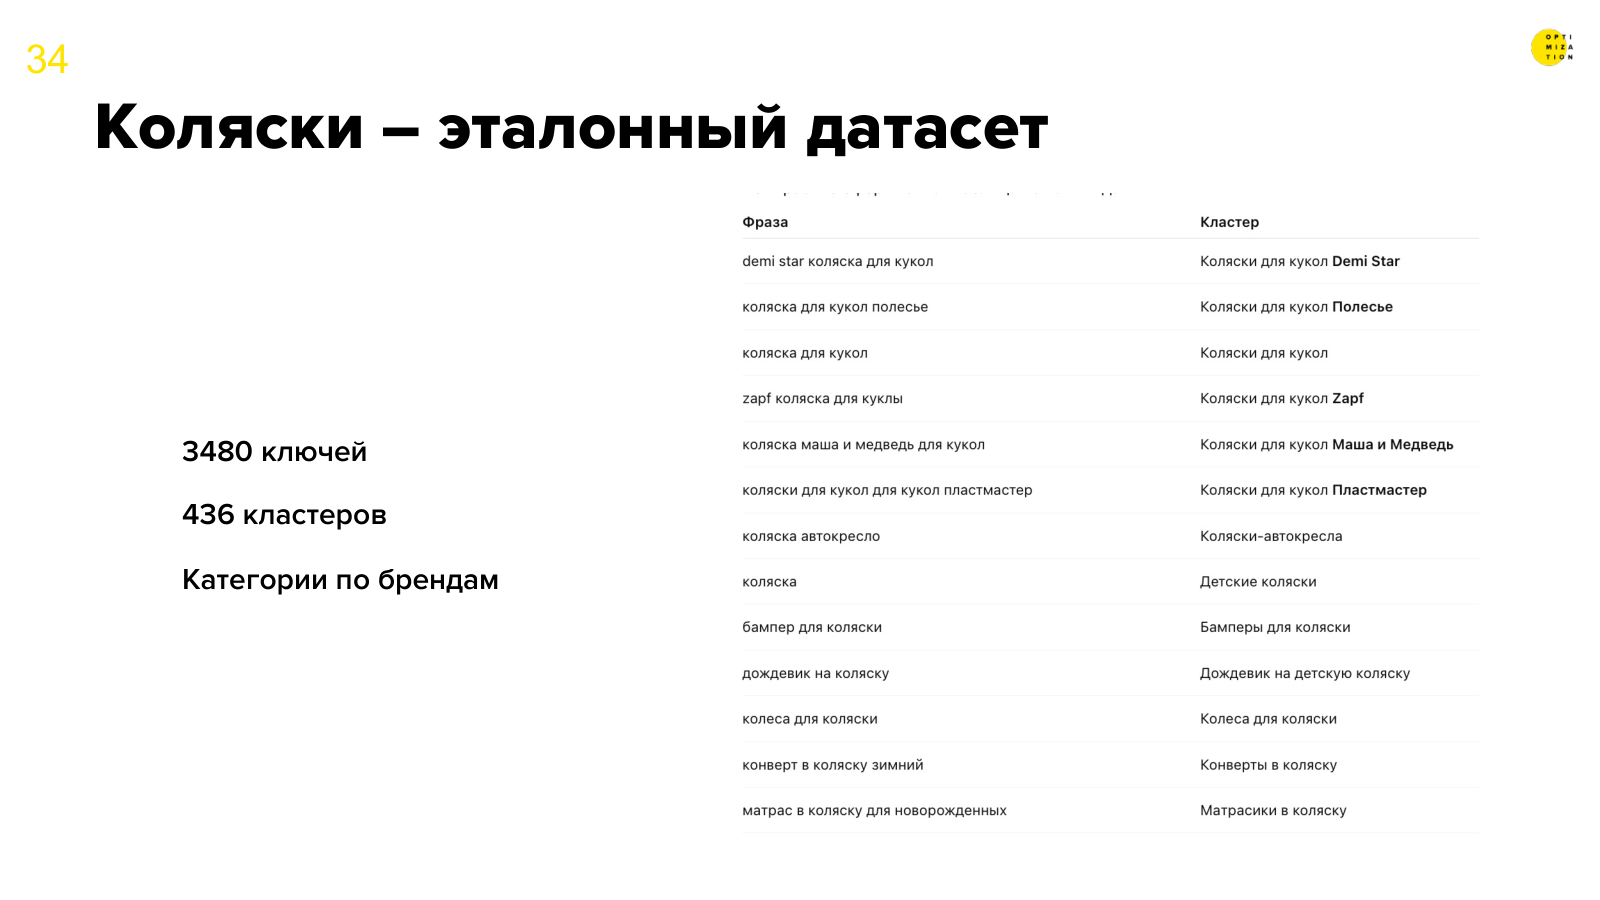 Слайд 33 — 3480 ключей, 436 кластеров, категории по брендам
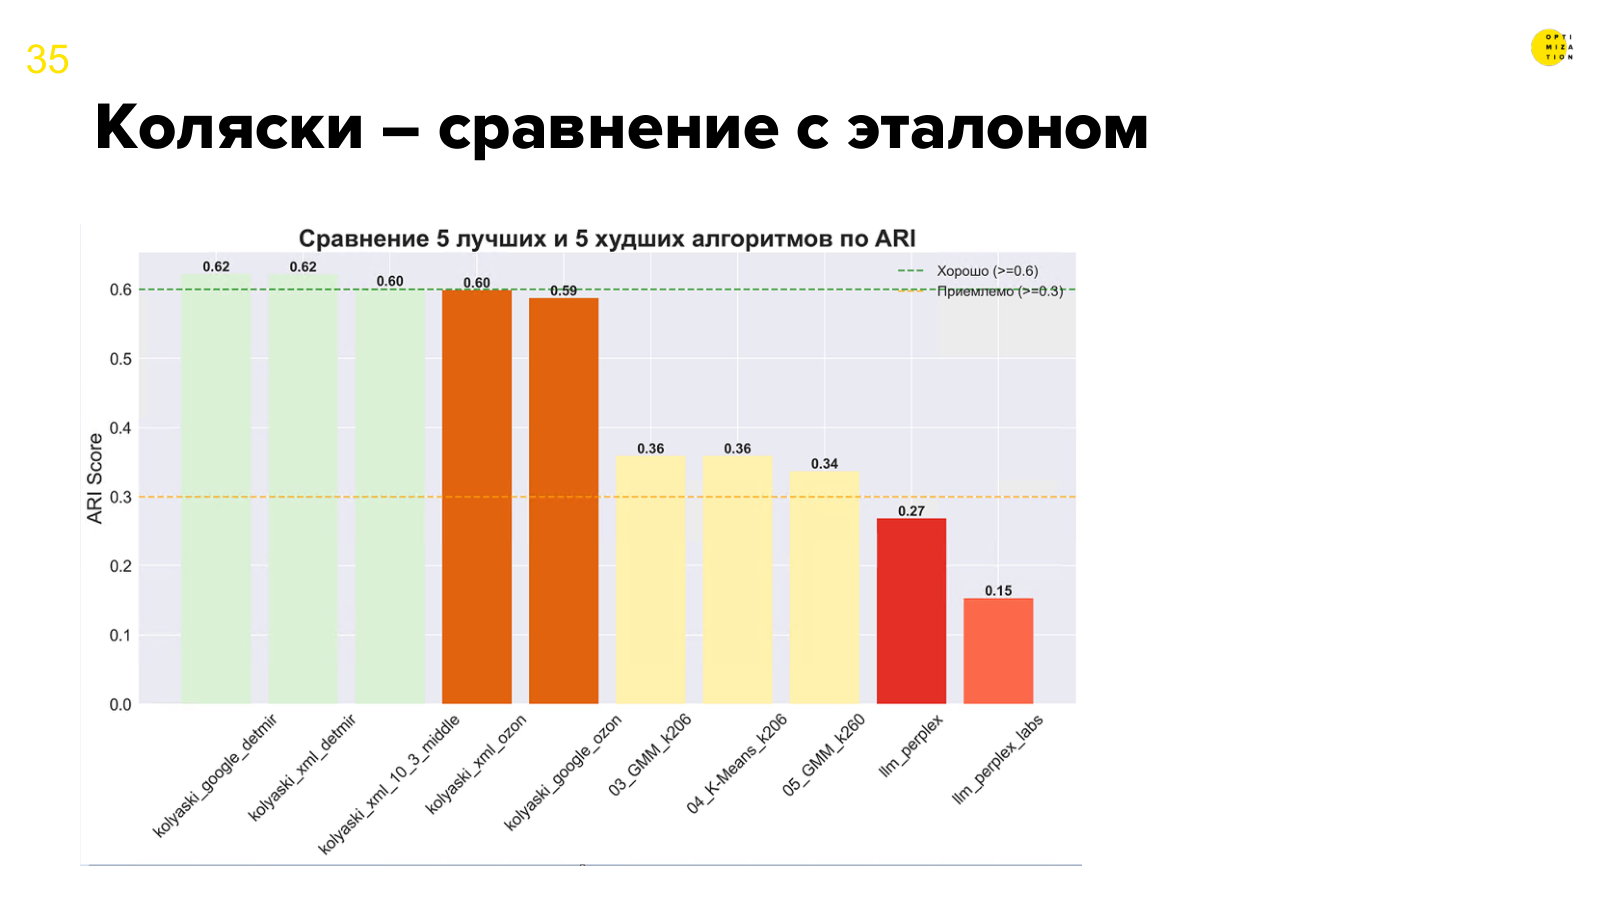 Слайд 34 — сравнение 5 лучших и 5 худших алгоритмов по ARI
| Метод | ARI |
|---|---|
| Google, по detmir.ru | 0,62 |
| Яндекс XML, по detmir.ru | 0,62 |
| Яндекс XML, 10_3, middle | 0,60 |
| Яндекс XML, по ozon.ru | 0,60 |
| Google, по ozon.ru | 0,59 |
| Эмбеддинги, GMM, k = 206 | 0,36 |
| Эмбеддинги, K-Means, k = 206 | 0,36 |
| Эмбеддинги, GMM, k = 260 | 0,34 |
| LLM, Perplexity | 0,27 |
| LLM, Perplexity Labs | 0,15 |
Лидируют кластеризации по сайтам-лидерам — «Детский мир» и OZON — и middle по Яндекс XML. LLM внизу.
На автозапчастях LLM показали идеальный результат, а на более сложной товарке с тегами — провалились. Это и есть главная претензия к нейросетям в задаче кластеризации: результат нестабилен и непредсказуем от ниши к нише.
Эксперимент 4. Кредиты
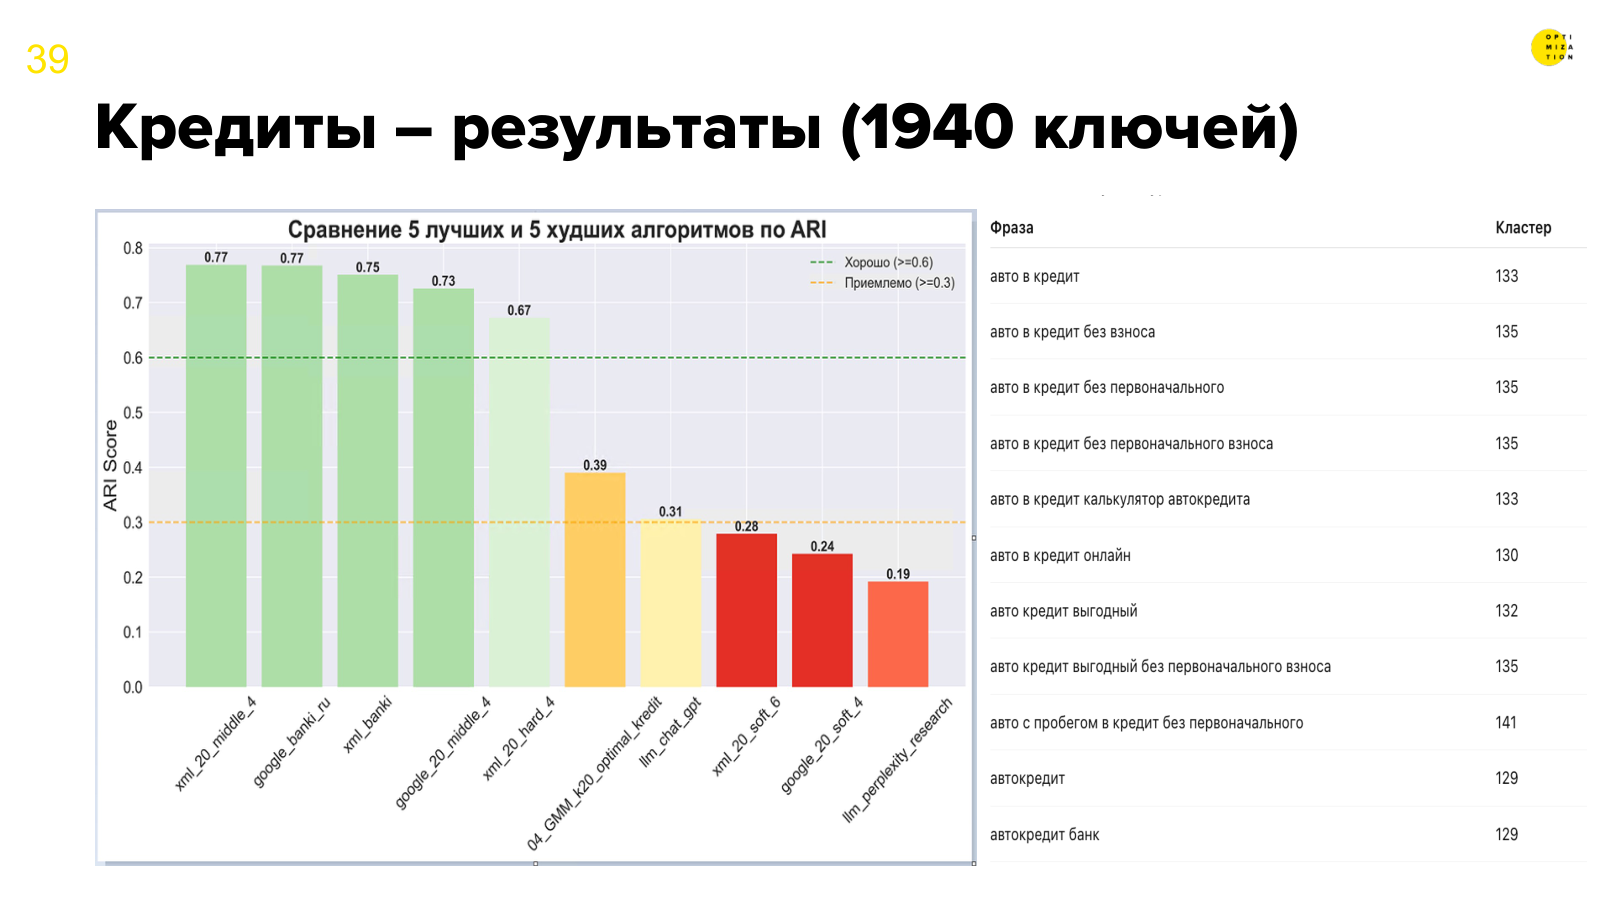 Слайд 38 — 1940 ключей, сравнение алгоритмов по ARI
| Метод | ARI |
|---|---|
| Яндекс XML, ТОП-20, middle 4 | 0,77 |
| Google, по banki.ru | 0,77 |
| Яндекс XML, по banki.ru | 0,75 |
| Google, ТОП-20, middle 4 | 0,73 |
| Яндекс XML, ТОП-20, hard 4 | 0,67 |
| Эмбеддинги, GMM, k = 20 | 0,39 |
| LLM, ChatGPT | 0,31 |
| Яндекс XML, ТОП-20, soft 6 | 0,28 |
| Google, ТОП-20, soft 4 | 0,24 |
| LLM, Perplexity Research | 0,19 |
Картина повторяется: лидируют сайты-лидеры ниши и middle-пороги, LLM внизу. Отдельно стоит зафиксировать: soft-кластеризация показала одни из худших результатов во всех экспериментах.
Зачем мудрить, есть же Яндекс.Вебмастер?
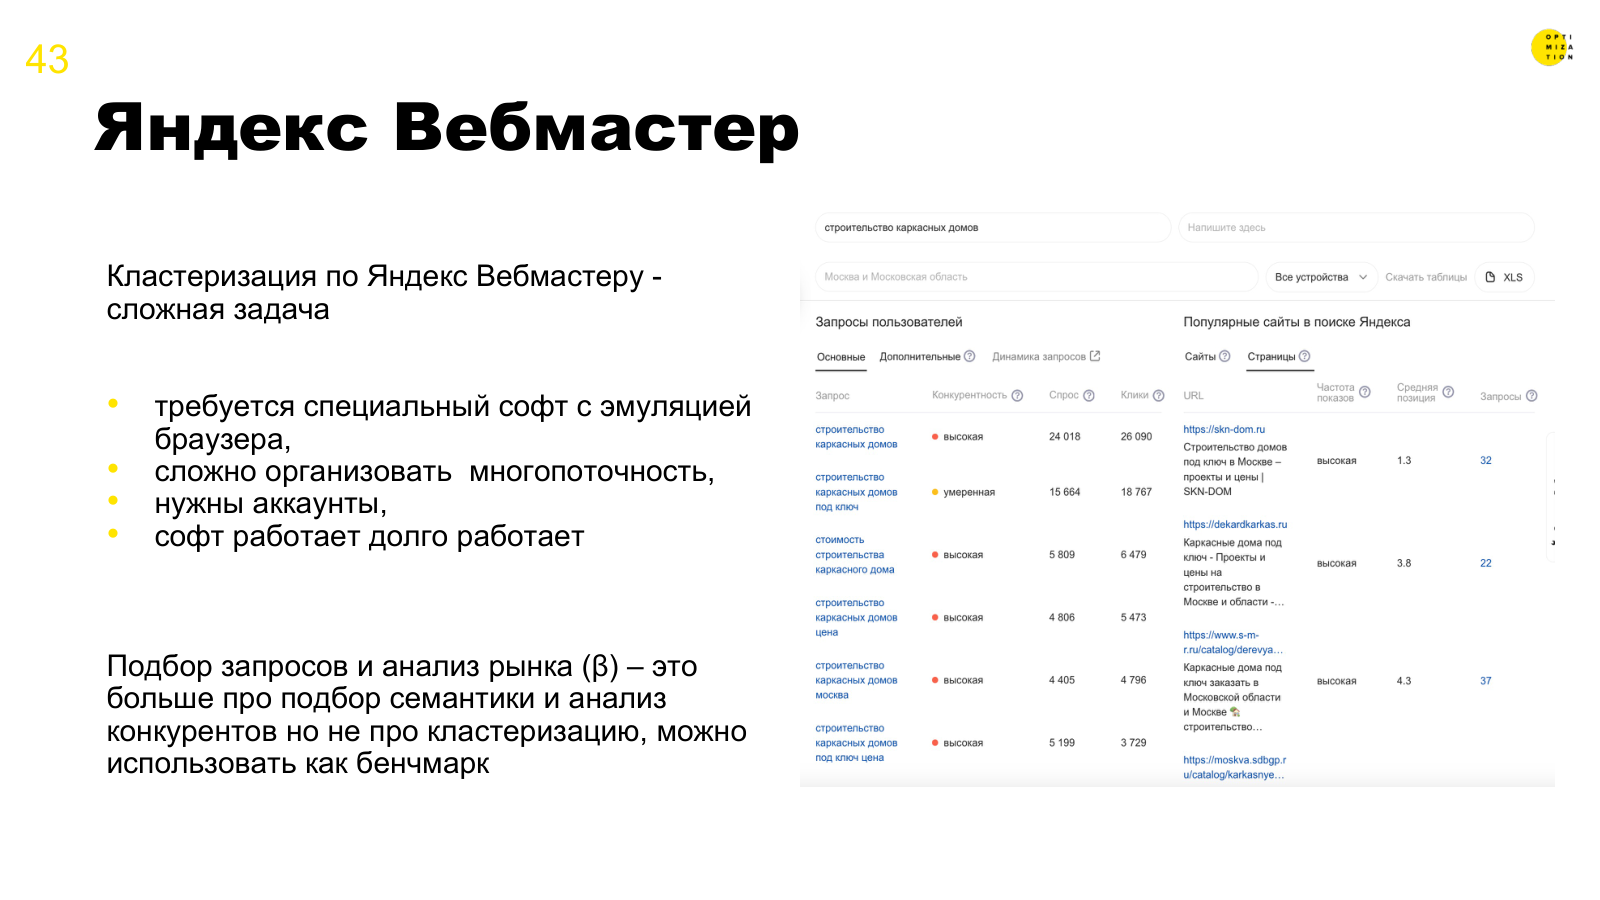 Слайд 41 — ограничения Яндекс.Вебмастера
Кластеризация по Яндекс.Вебмастеру — сложная задача:
- требуется специальный софт с эмуляцией браузера;
- сложно организовать многопоточность;
- нужны аккаунты;
- софт работает долго.
Раздел «Подбор запросов и анализ рынка» (β) — это больше про подбор семантики и анализ конкурентов, но не про кластеризацию. Использовать его можно как бенчмарк. Несколько экспериментов было проведено, но результат не оправдал затрат, поэтому в доклад цифры не вошли.
Парсер и кластеризатор для Яндекс.Вебмастера доступен в Colab: открыть (слайд 42).
Выводы
 Слайд 44 — выводы
Кластеризация по ТОПу. Идеального алгоритма не существует, всё зависит от ниши, конкуренции и заспамленности ТОПов. В конкурентных нишах имеет смысл делать сравнение по сайту-лидеру. YaXML и Live в Яндексе дают одинаковые результаты — разницы в цифрах нет, при том что Live снимать дольше и сложнее.
Кластеризация по эмбеддингам. Всё зависит от того, как подобраны веса внутренних метрик. В среднем результат хуже, чем по ТОПу. Лучший алгоритм — агломеративная кластеризация. Кластеры при этом могут сильно отличаться от кластеризации по ТОПу.
Кластеризация по LLM. Нестабильный результат.
Яндекс.Вебмастер. Скорее про сбор семантики, чем про кластеризацию.
 Слайд 45
Идеального метода не существует. С первого раза в лоб нормальный результат получить вряд ли удастся — так или иначе придётся комбинировать несколько методов.
Общие рекомендации
Слайд 46
Кластеризация по LLM показала худшие результаты. Использовать можно справочно, как одну из метрик.
Кластеризация по эмбеддингам по косинусному расстоянию отлично отрабатывает при разнородной семантике, но в сложных нишах показывает средний результат.
Кластеризация по условным сайтам-лидерам (Exist.ru, OZON) — можно использовать как бенчмарк.
Кластеризация по эмбеддингам рекомендована в ТОПах с низкой конкуренцией, в нишах, где мало сайтов и невозможно качественно сделать кластеризацию по ТОПу.
Вариант использования
Слайд 47
Основной метод — ТОП-20 выдачи Яндекса (YaXML) или Google, настройки middle от 4 до 6.
Бенчмарк № 1 — кластеризация по сайтам-лидерам ниши.
Бенчмарк № 2 — Яндекс.Вебмастер: посмотреть, как сгруппированы URL конкурентов, и, что важно, проверить, вся ли семантика собрана.
Бенчмарк № 3 — агломеративная кластеризация по эмбеддингам с оптимизацией по диапазону количества кластеров.
Финальная доводка — руками SEO-специалиста.
Ответы на вопросы
Какой сервис кластеризации посоветуете?
Вопрос не в сервисах — они делают примерно одно и то же: снимают выдачу и смотрят, для каких групп фраз повторяются URL. Есть вариации вроде гиперболической кластеризации, где предпочтение отдаётся сайтам из первой тройки, но по сути это всё та же кластеризация по ТОПу. В агентстве используются Арсенкин Тулс и KeyAssort. Результат сильно зависит не от софта, а от того, как выставлены пороги.
Кластеризация по эмбеддингам зависит от корпуса. Какой корпус использовали и сравнивали ли разные?
Использовался не корпус слов, а модель от Яндекса. «Корпус» — это подход 2015 года, проекты вроде RusVectores. Современные модели работают иначе: у фраз «пластиковые окна» и «пластиковое окно» будут разные векторы, потому что используется positional encoding. В эксперименте порядка 100 000 запросов прогонялись через модель, для каждой фразы извлекался вектор.
Сравнение эмбеддинг-моделей в этом эксперименте не проводилось. Оно было годом ранее, в отдельном докладе: сравнивались модели OpenAI, Яндекса, Сбера и Google. Оценку давали сеошники — им предлагались результаты поиска близких фраз разными моделями, и они голосовали, какая отработала корректнее. По итогам голосования победила модель Яндекса, поэтому она и использовалась.
Материалы доклада: видео · презентация
Инструмент из доклада: бесплатный бот для проверки вхождений ключевых фраз и n-грамм на странице — @ngram_check_bot. Отправляете кластер запросов, следом URL — семантика бьётся на n-граммы, лемматизируется, считаются вхождения. Результат примерно за 30 секунд (слайд 49).
Автор: Владислав Папернюк, агентство «Сайт-Активатор» · телеграм-канал Python SEO 2 нейрона · курс Python SEO Нейросети