
Текстовый анализ в эпоху нейросетей: эксперименты с SRW-словами и эмбеддингами
Расшифровка доклада на конференции Optimization 2024. Номера слайдов соответствуют презентации.
Работает ли текстовый анализ в эпоху накрутки ПФ
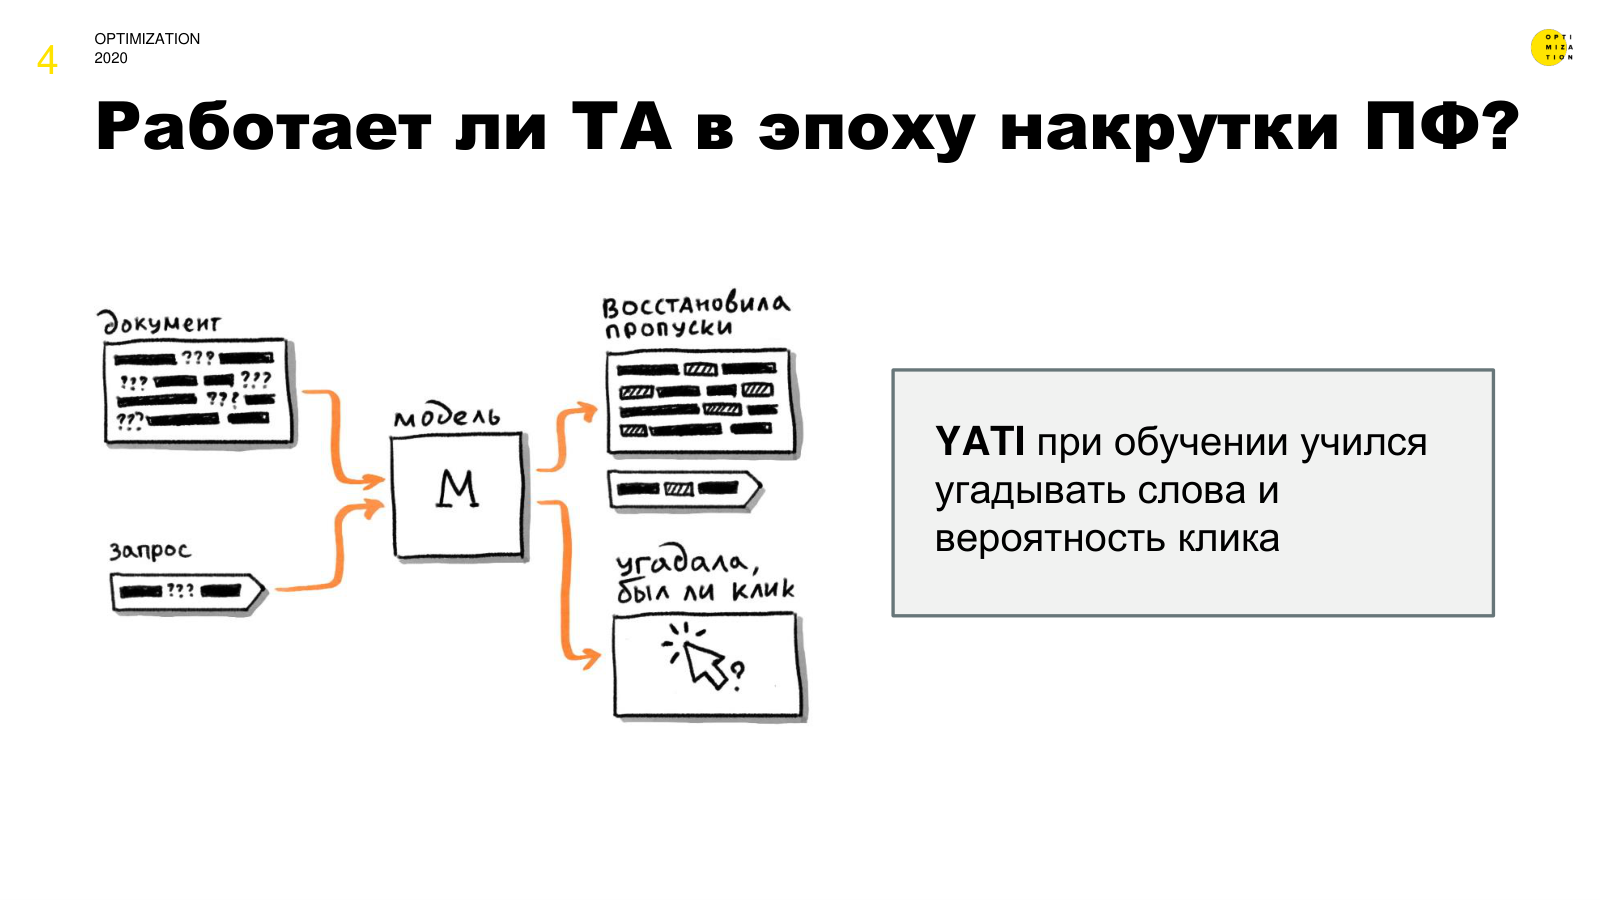 Слайд 4 — как обучался YATI
Ответ даёт слайд из презентации самого Яндекса, показывающий, как обучалась нейросеть YATI. Она обучалась на текстовых документах методом маскирования — угадывала слова и вероятность клика. Значит, текст находится под капотом YATI. Принимаем это как аксиому.
Как устроен любой текстовый анализатор
 Слайд 5 — общая схема
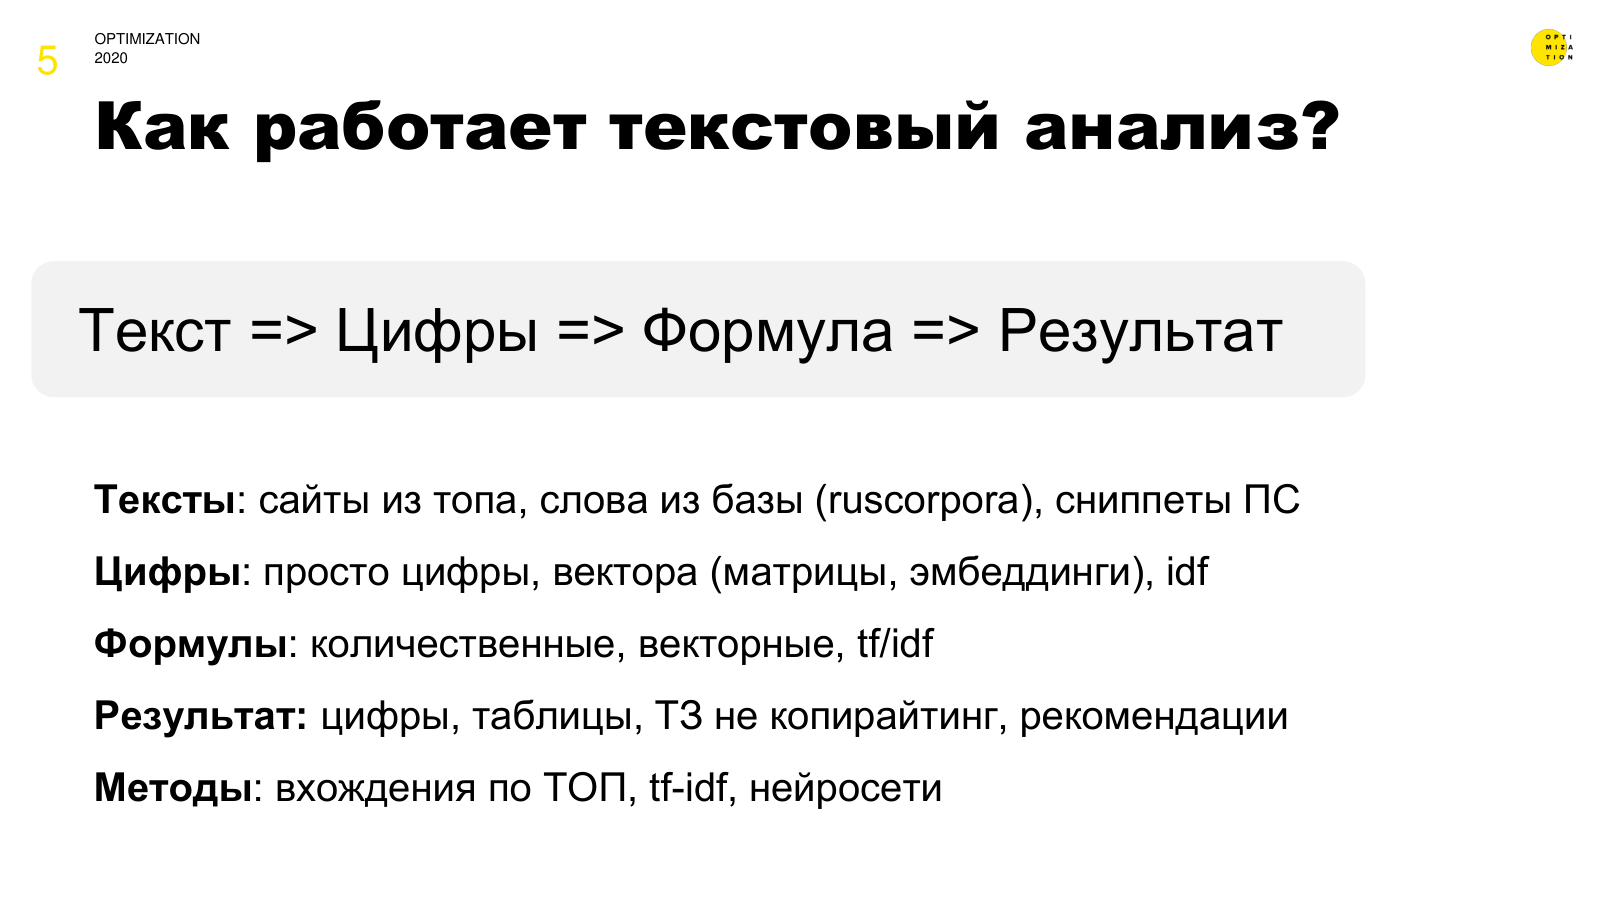
Схема всегда одна: текст → цифры → формула → результат.
- Тексты: сайты из ТОПа, слова из базы (ruscorpora), сниппеты поисковых систем.
- Цифры: просто цифры, векторы (матрицы, эмбеддинги), IDF.
- Формулы: количественные, векторные, TF-IDF.
- Методы: вхождения по ТОПу, TF-IDF, нейросети.
- Результат: цифры, таблицы, ТЗ на копирайтинг, рекомендации.
Проблема первая: считаем вхождения в ТОПах
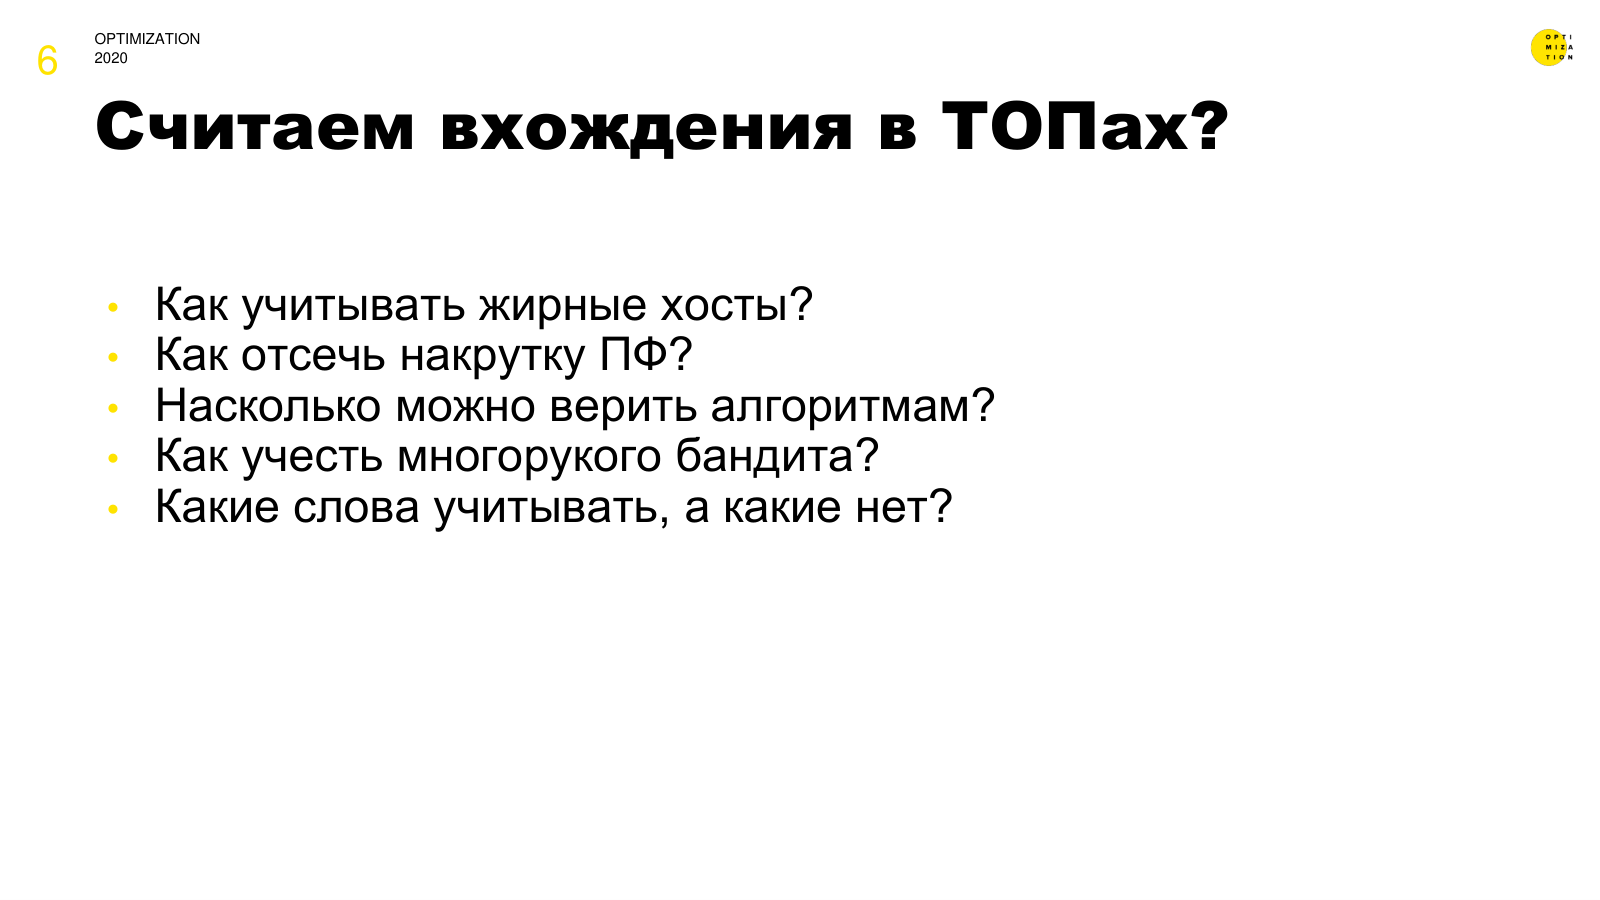 Слайд 6 — вопросы к методу
Самый простой подход, который неплохо работал лет десять назад: взять сайты из ТОПа, посчитать вхождения и скопировать у себя медианное значение, может быть слегка проспамив.
Проблема в том, что непонятно, на кого сейчас ориентироваться и кого брать за эталон:
- Как учитывать жирные хосты?
- Как отсечь накрутку ПФ?
- Насколько можно верить алгоритмам?
- Как учесть многорукого бандита?
- Какие слова учитывать, а какие нет?
Проблема вторая: TF-IDF и BM25
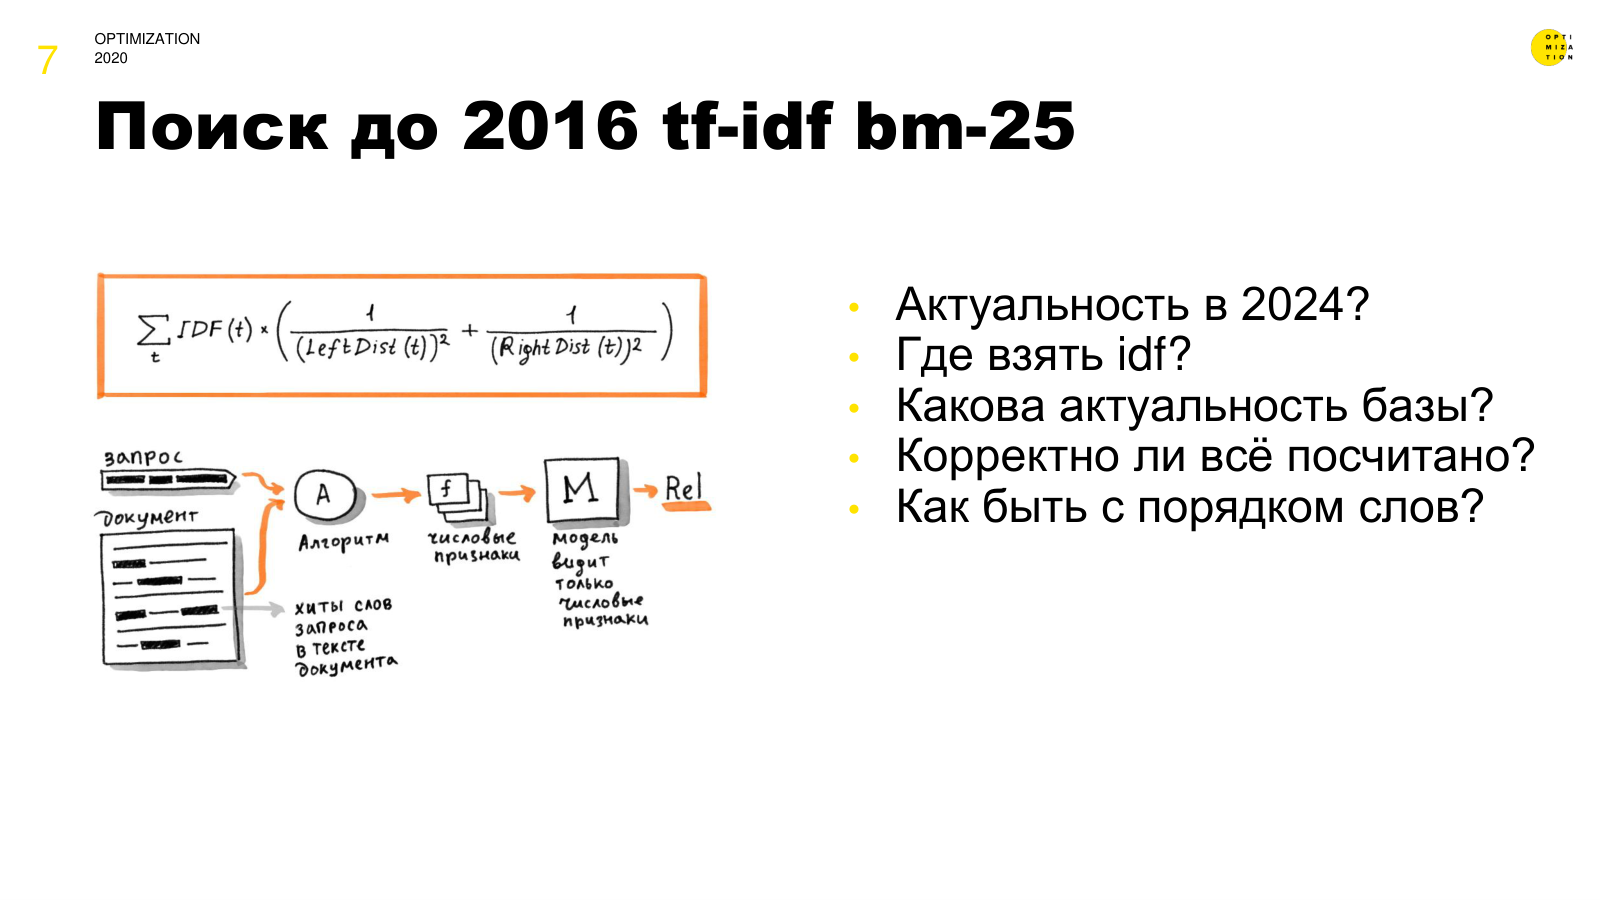 Слайд 7 — вопросы к классике
- Актуальность в 2024? По данным Яндекса, алгоритм перестал использоваться в 2016 году, хотя частично применяется для title и подобных зон.
- Где взять IDF?
- Какова актуальность базы? Например, команда SEOLemma сообщала, что прочекала порядка 4 млн страниц и посчитала свою базу IDF.
- Корректно ли всё посчитано?
- Как быть с порядком слов?
Как работают нейросети: необходимый минимум
Обучение методом маскирования
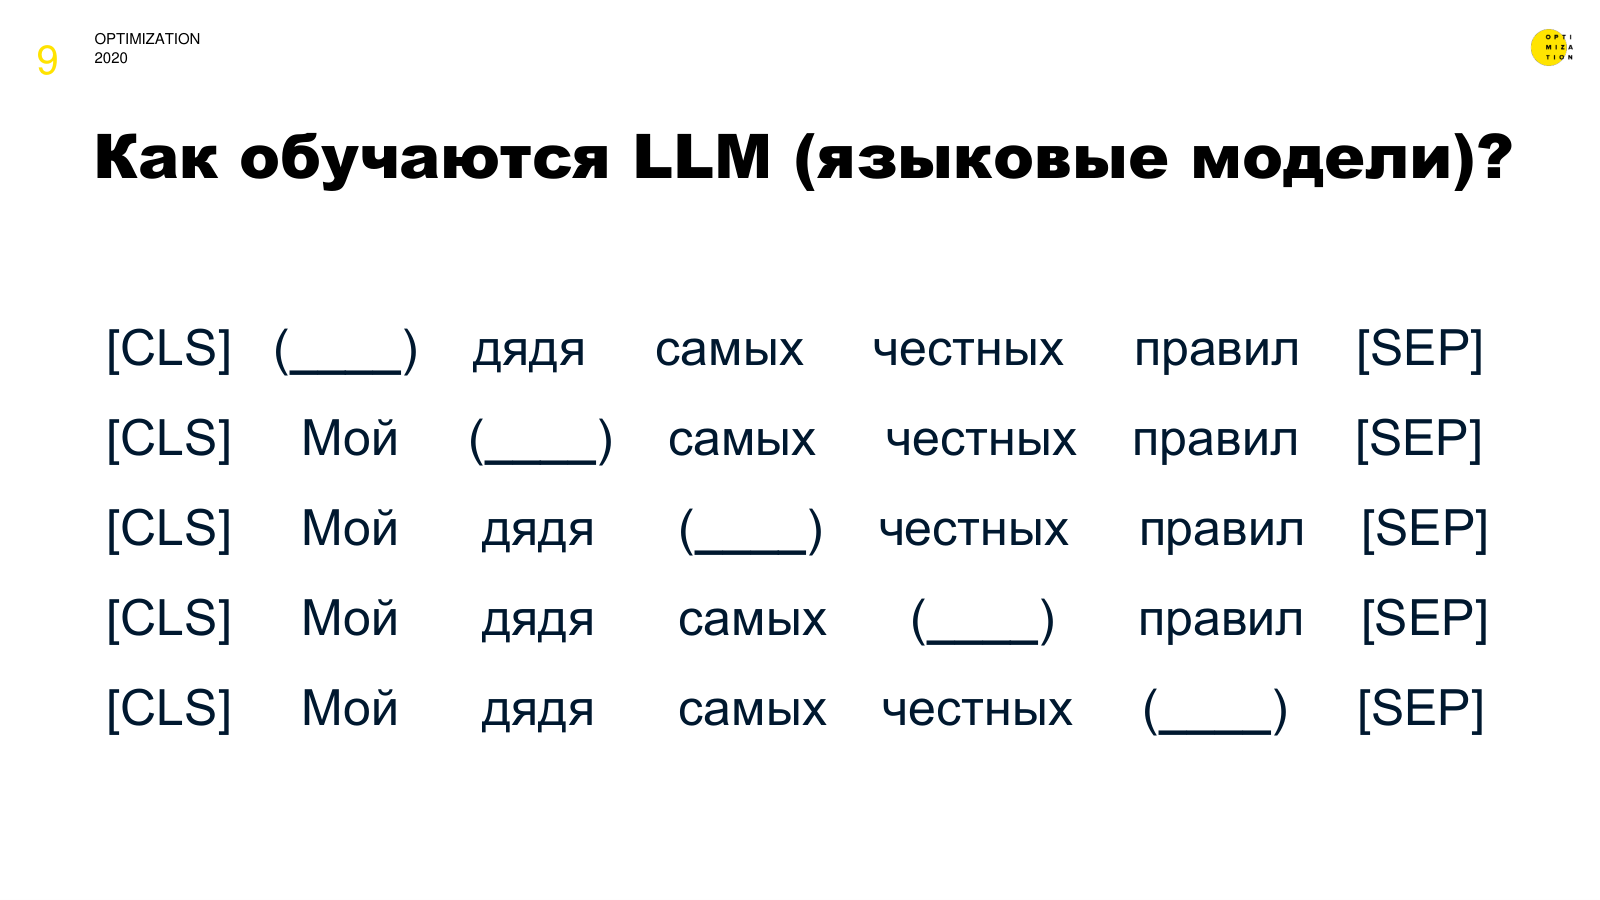 Слайд 9 — механизм маскирования
[CLS]  (____)  дядя   самых  честных  правил [SEP]
[CLS]   Мой   (____)  самых  честных  правил [SEP]
[CLS]   Мой    дядя   (____) честных  правил [SEP]
[CLS]   Мой    дядя   самых   (____)  правил [SEP]
[CLS]   Мой    дядя   самых  честных  (____) [SEP]
В нейросеть подаются предложения одно за другим, одно слово закрывается маской. Угадала — поощряется, не угадала — штрафуется. [CLS] — токен начала последовательности, [SEP] — токен конца. Так модель выучивает устойчивые связки слов и их взаимное расположение.
Слово как вектор
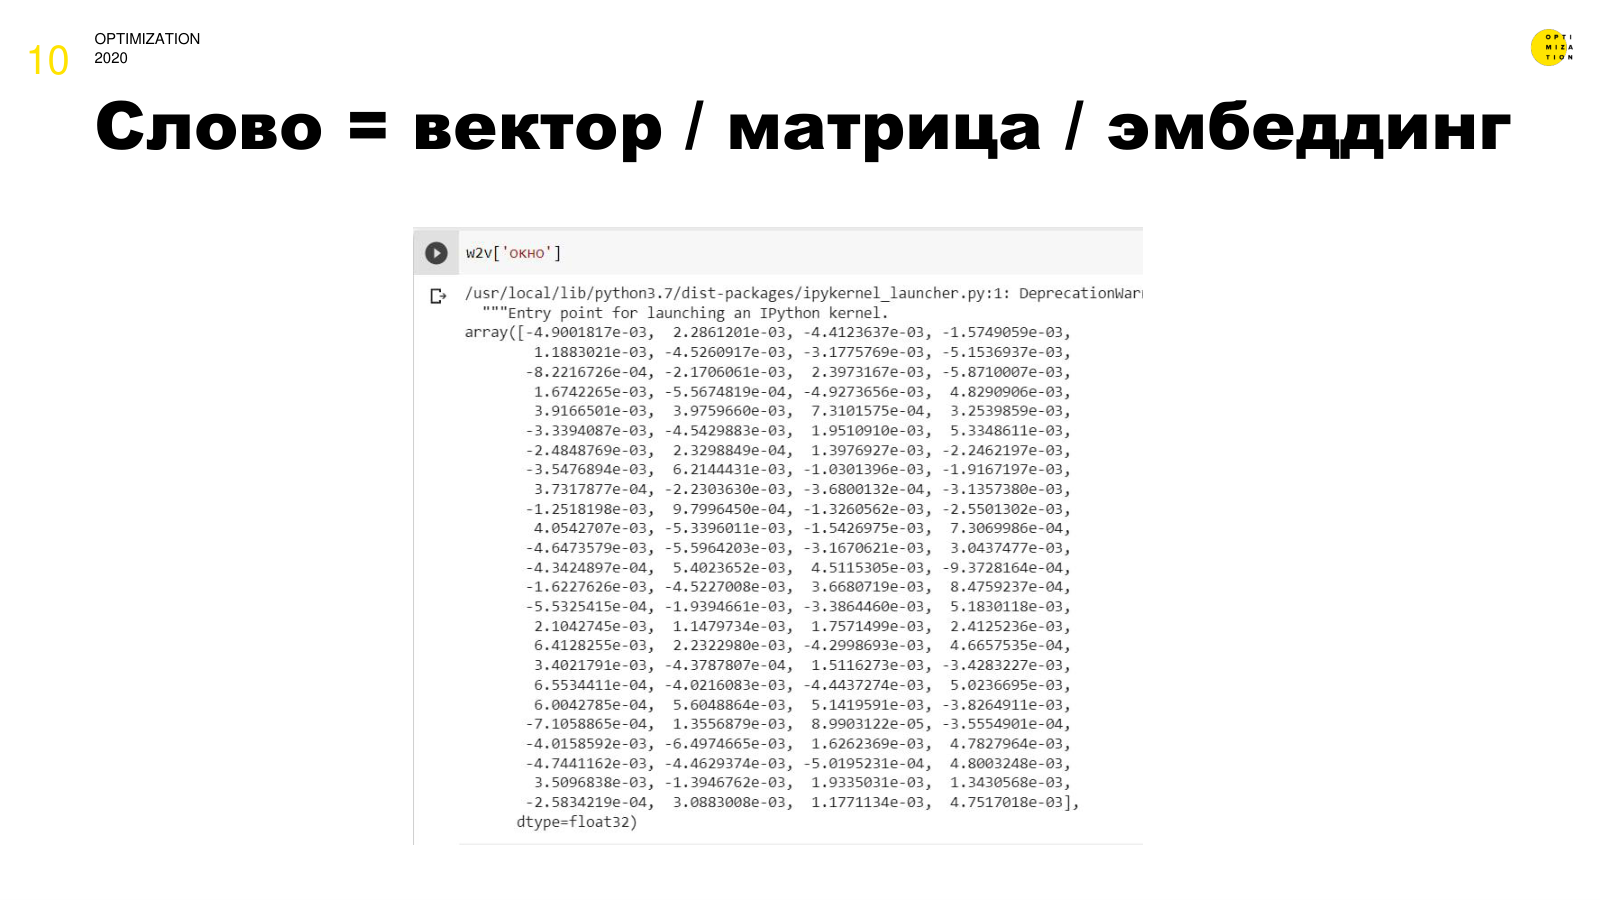 Слайд 10 — эмбеддинг
Под капотом — векторы. В начале обучения числа генерируются случайно, но по мере прогона текстов возникает эффект: похожие по смыслу слова начинают указывать примерно в одну сторону.
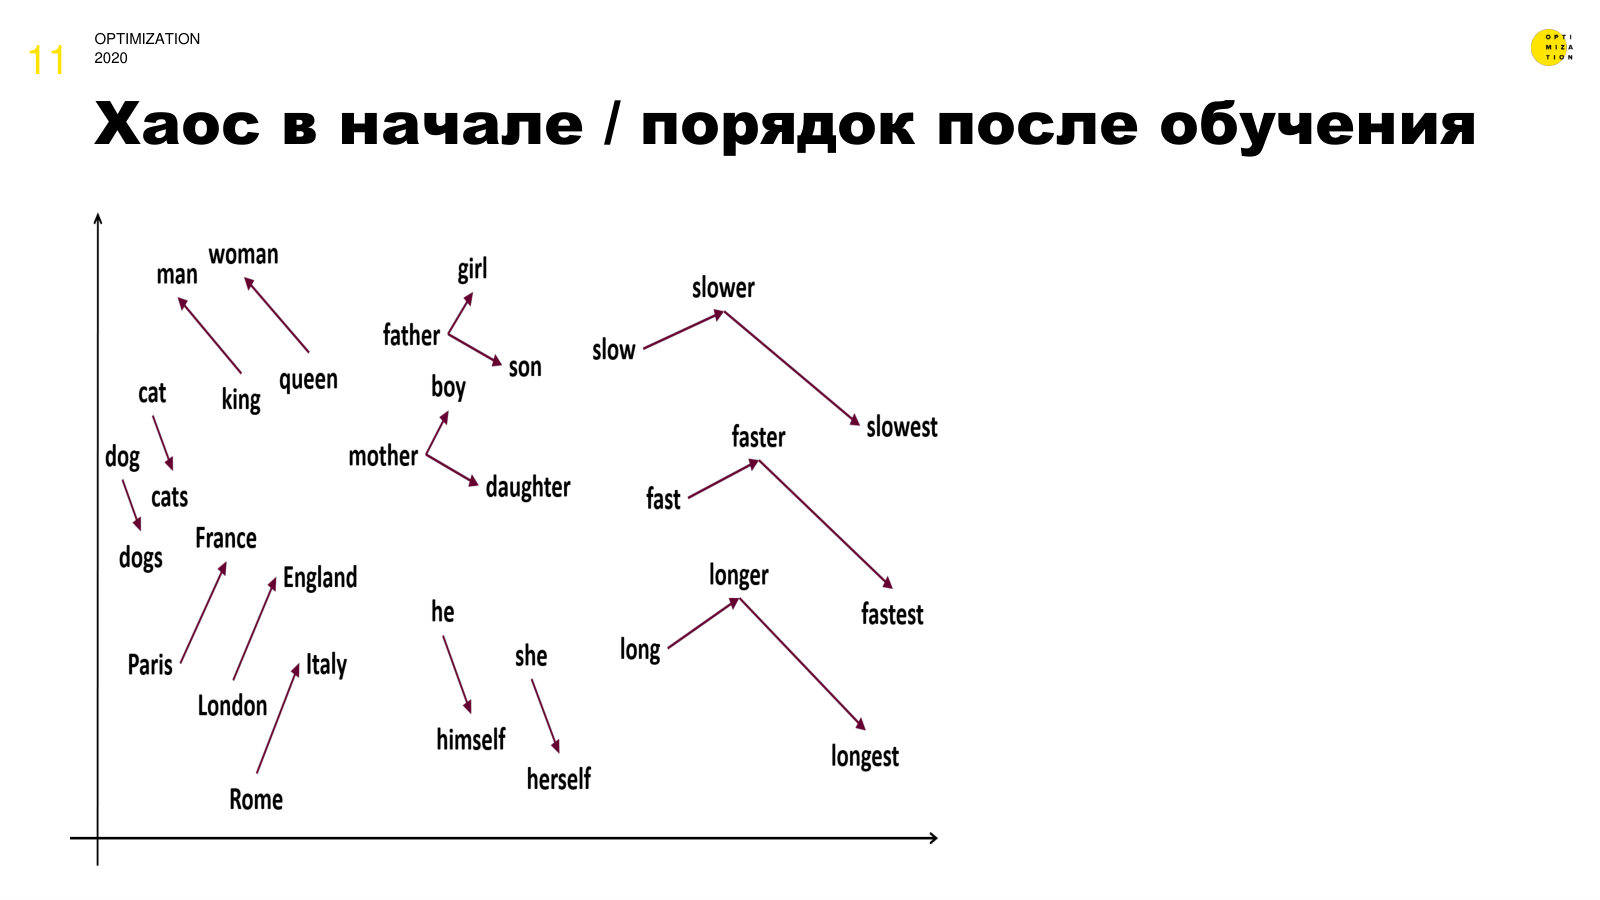 Слайд 11 — до и после обучения
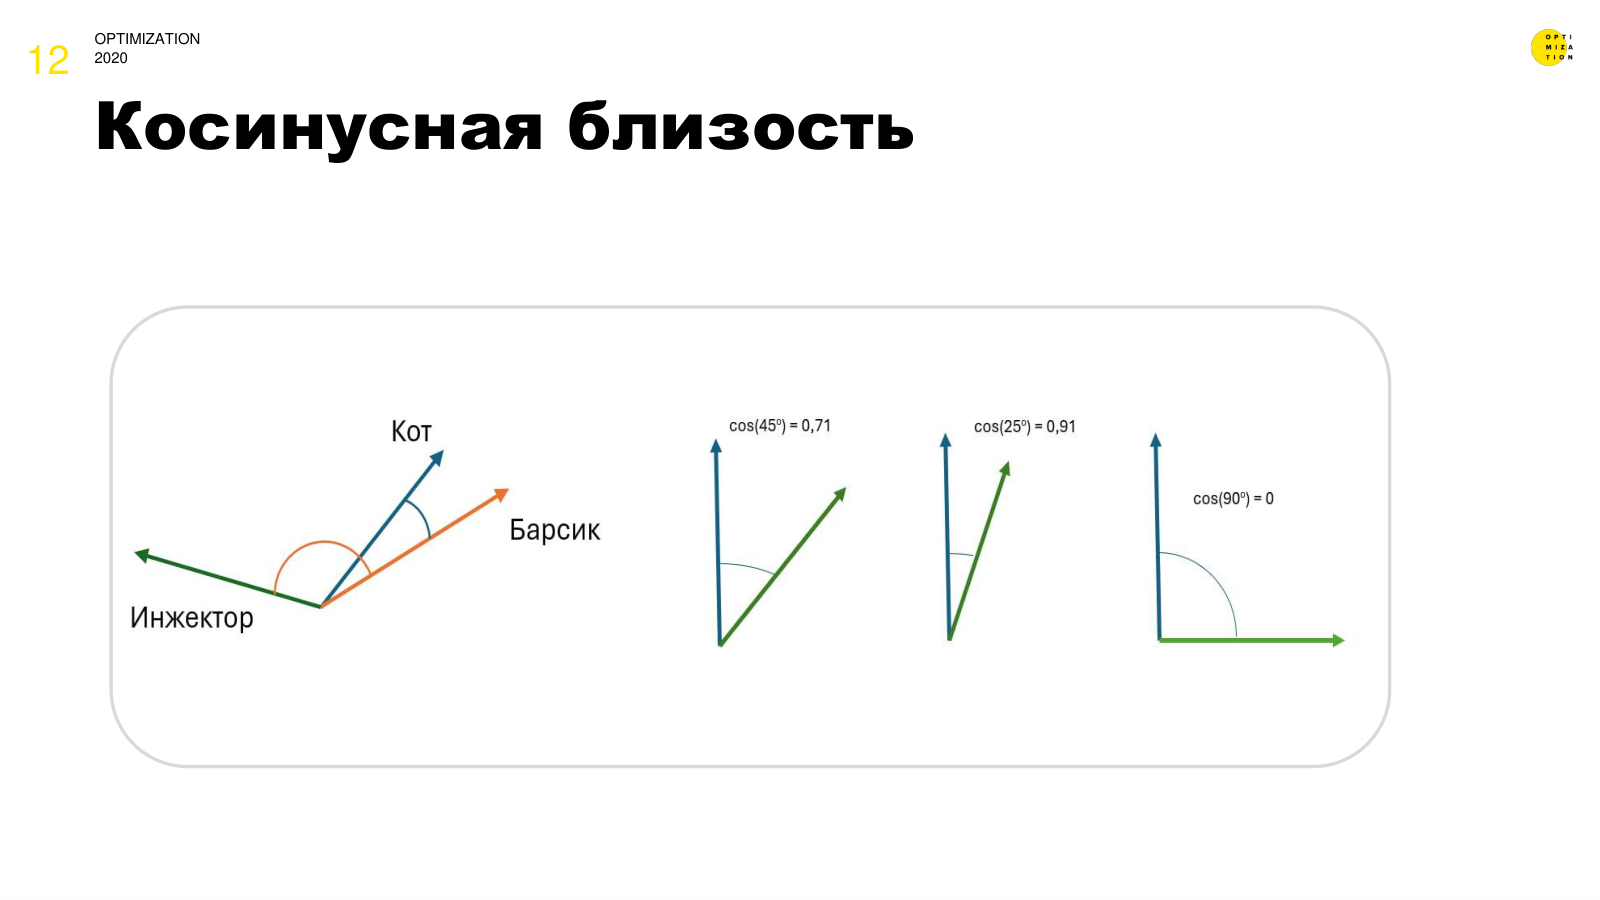 Слайд 12 — косинусная близость
Мерило похожести — косинусная близость между векторами. «Кот», «барсик», «котёнок», «кошка» направлены примерно в одну сторону, а «инжектор», «двигатель», «тормозные колодки» — в другую.
Где взять векторы
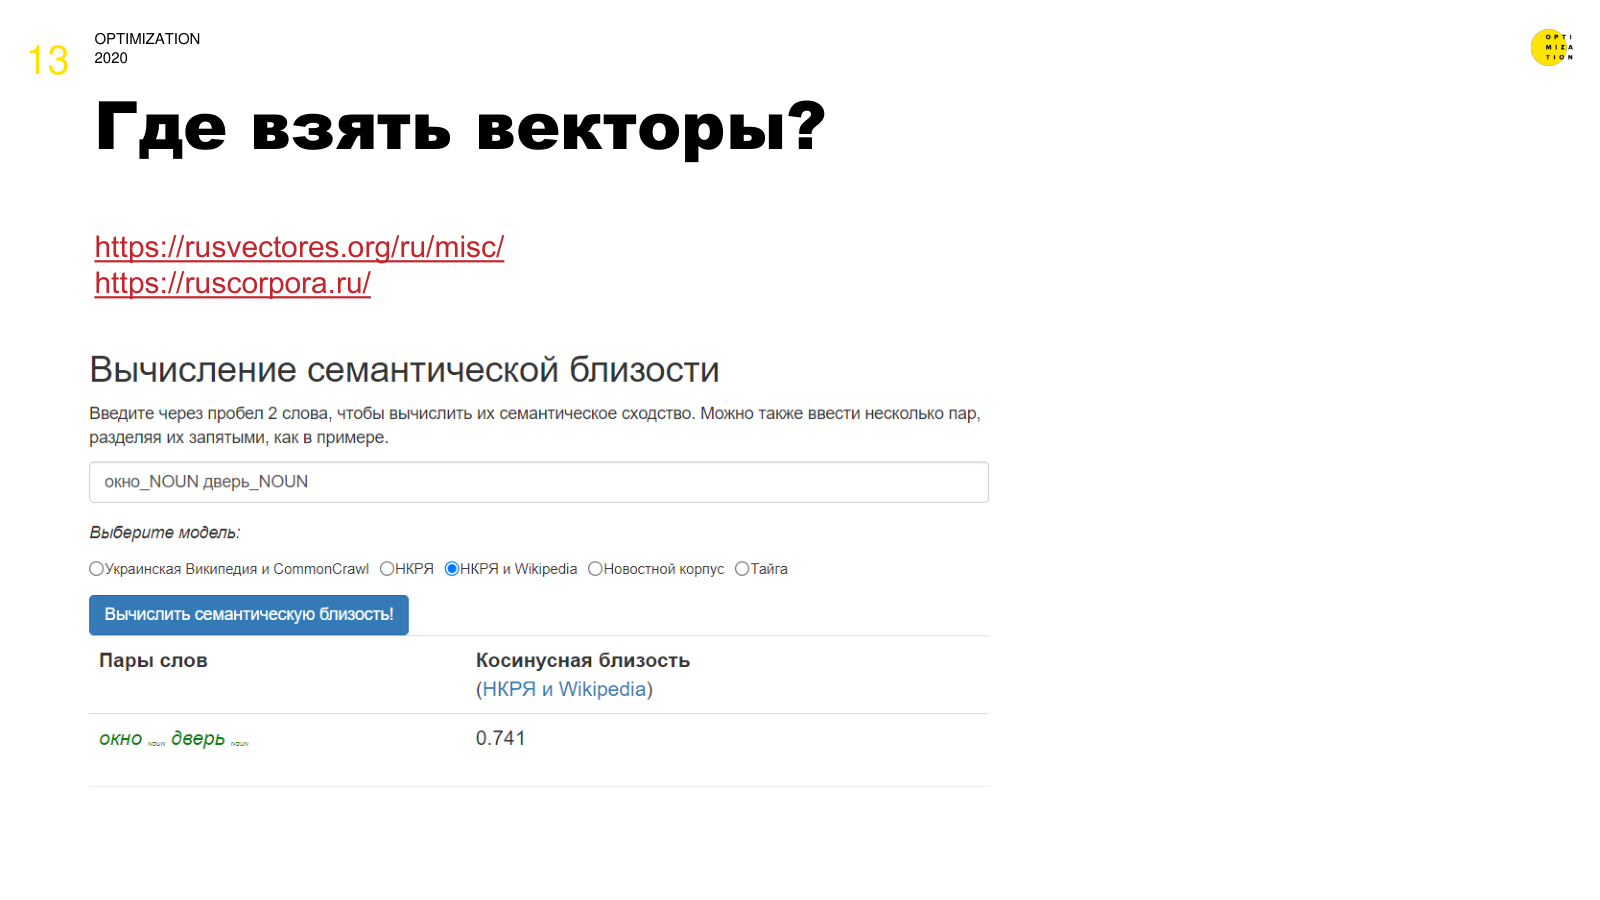 Слайд 13 — открытые проекты
Открытые источники — RusVectores и Национальный корпус русского языка. Интерфейс там неудобный: слово нужно вводить лемматизированным и с указанием части речи через нижнее подчёркивание.
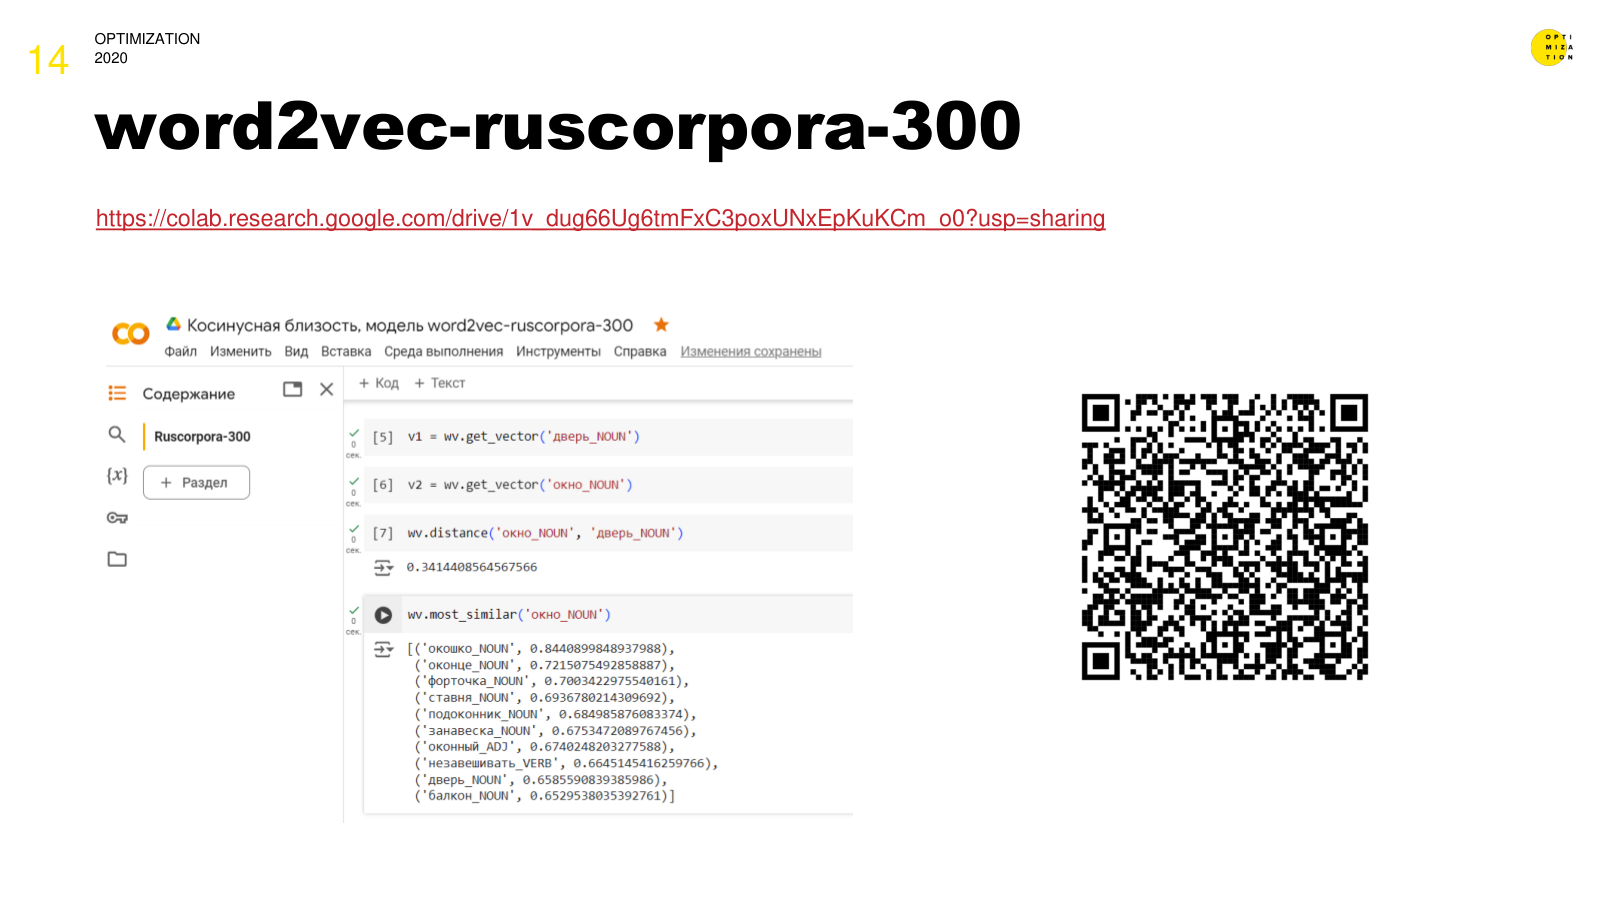 Слайд 14 — скрипт для работы с базой
Чтобы упростить работу, написан небольшой скрипт: открыть в Colab. В базе порядка 180 тысяч фраз.
Трансформеры: три ключевых механизма
 Слайд 15 — особенности архитектуры
Статья Attention Is All You Need от инженеров Google впервые представила архитектуру трансформеров, благодаря которой существует весь текущий зоопарк нейросетей. Три ключевых элемента: эмбеддинги, positional encoding, механизм attention.
Positional encoding: порядок слов важен
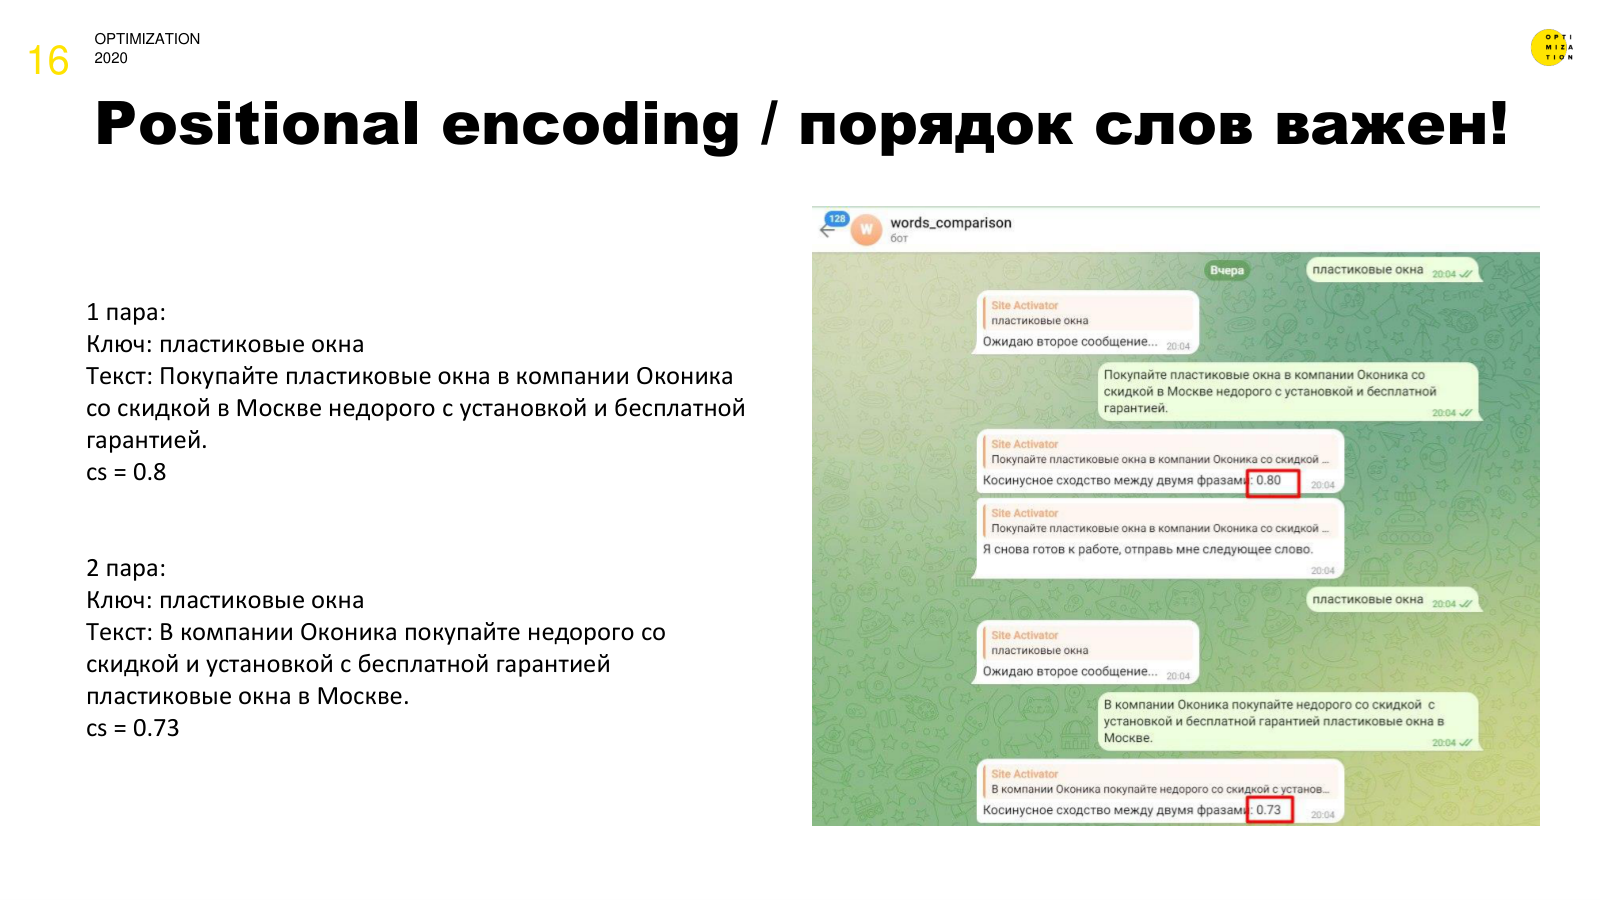 Слайд 16 — простой тест
Ключ: «пластиковые окна».
Пара 1. «Покупайте пластиковые окна в компании Оконика со скидкой в Москве недорого с установкой и бесплатной гарантией» → cs = 0,8
Пара 2. «В компании Оконика покупайте недорого со скидкой и установкой с бесплатной гарантией пластиковые окна в Москве» → cs = 0,73
Слова те же, изменён только порядок — разница около 15–20%. Под капотом теста модель textEmbedding от Яндекса. Позиция слова в предложении зашивается прямо в код, так что тезис «порядок слов важен» имеет под собой техническое основание.
Где брать эмбеддинги
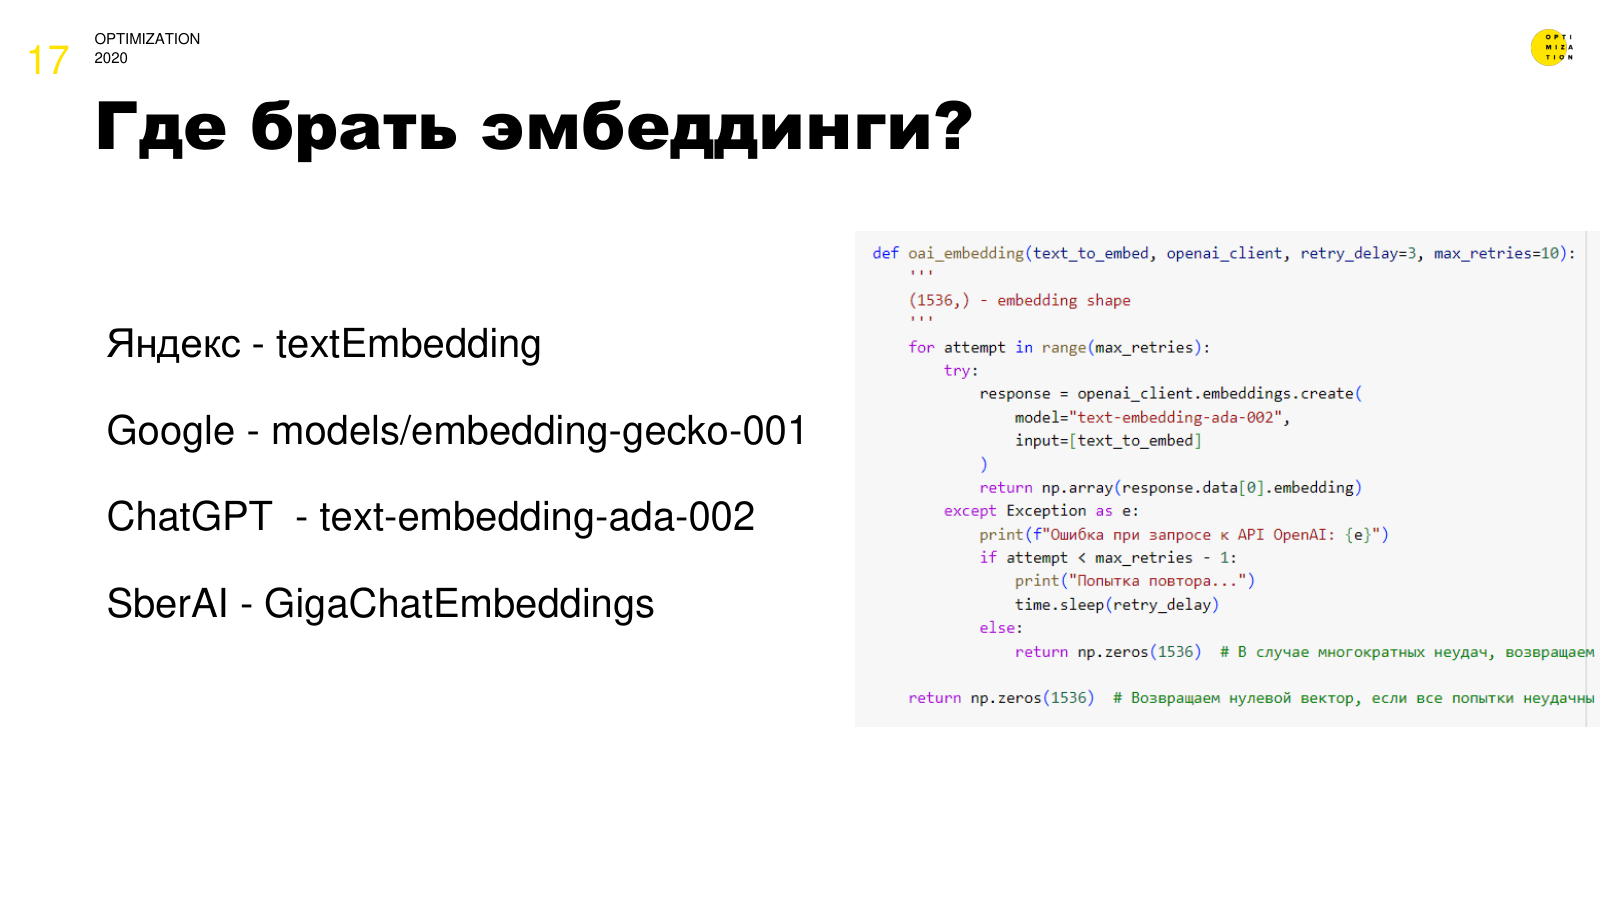 Слайд 17 — доступные модели
- Яндекс —
textEmbedding - Google —
models/embedding-gecko-001 - ChatGPT —
text-embedding-ada-002 - SberAI —
GigaChatEmbeddings
Механизм attention
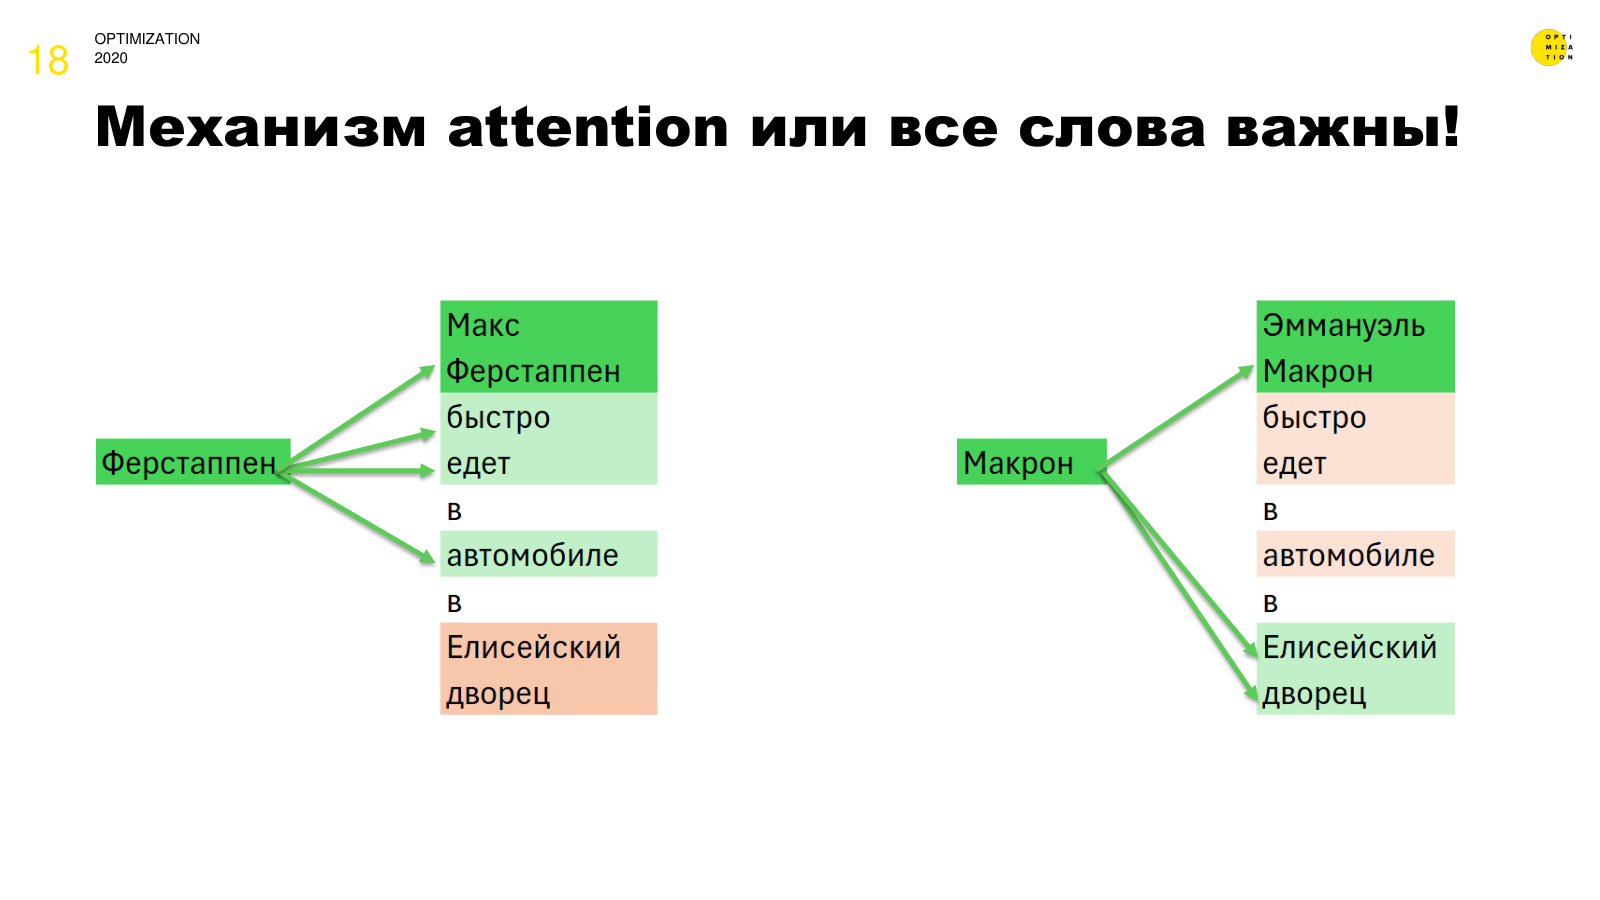 Слайд 18 — все слова важны
Attention определяет, какие слова в предложении сильнее связаны между собой. В примере с одинаковой конструкцией, но разными именами: у Ферстаппена сильнее связь с «быстро едет» и «автомобиль», у Макрона — с «Елисейским дворцом».
Гипотеза
 Слайд 19 — формулировка
Механизм attention учитывает отношения слов, языковые модели выстраивают устойчивые связки слов между собой. А что если существуют семантически релевантные слова (SRW) для ключа, добавление которых влияет на релевантность текста?
Уточнение по терминологии: дальше используется термин SRW — semantically related words, а не LSI. LSI — это принципиально другой алгоритм, и путать их не стоит.
Эксперимент 1. Влияние SRW-слов
 Слайд 21 — два способа поиска
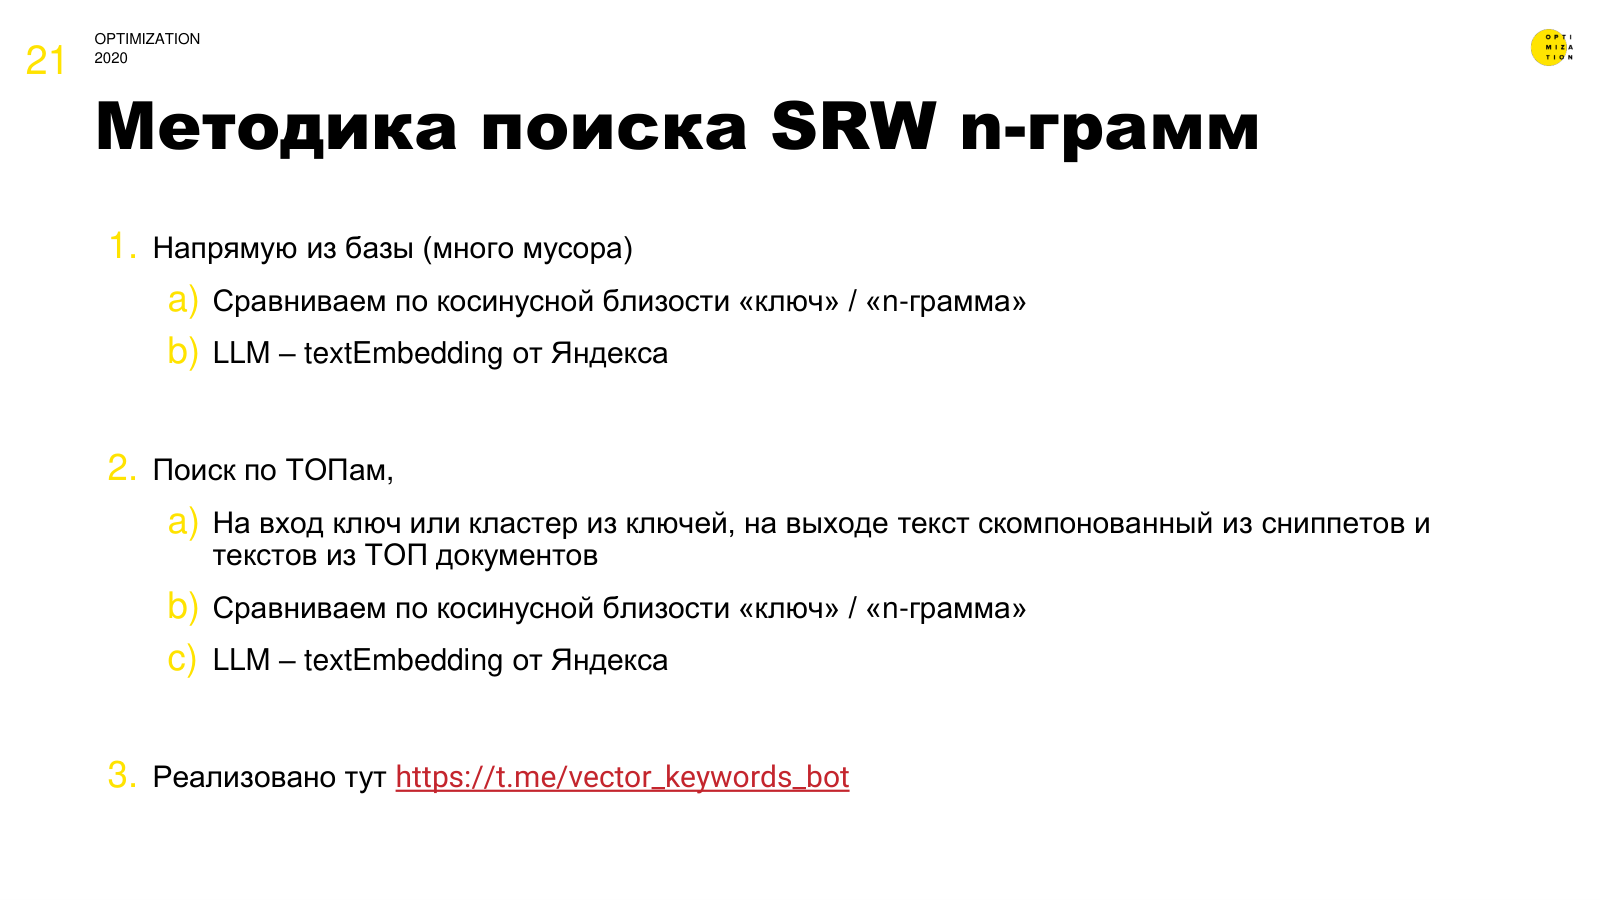
Способ 1. Напрямую из базы — много мусора. Сравниваем по косинусной близости пары «ключ» / «n-грамма», модель — textEmbedding от Яндекса. Проблема: для ключа «окно» вылезет и автомобильное окно, и медицинский термин.
Способ 2. Поиск по ТОПам. На вход ключ или кластер ключей, на выходе текст, скомпонованный из сниппетов и текстов документов из ТОПа. Дальше — то же сравнение по косинусной близости.
Второй способ и реализован в боте @vector_keywords_bot. Бот бесплатный, отрабатывает 3–5 минут: за один запрос он снимает сниппеты, находит URL, которые встречаются в ТОПе по большинству запросов кластера, выкачивает их тексты в общий документ примерно на 200 тысяч слов и в несколько потоков считает по нему близость.
 Слайд 23 — распределение по базе ≈150 тыс. слов
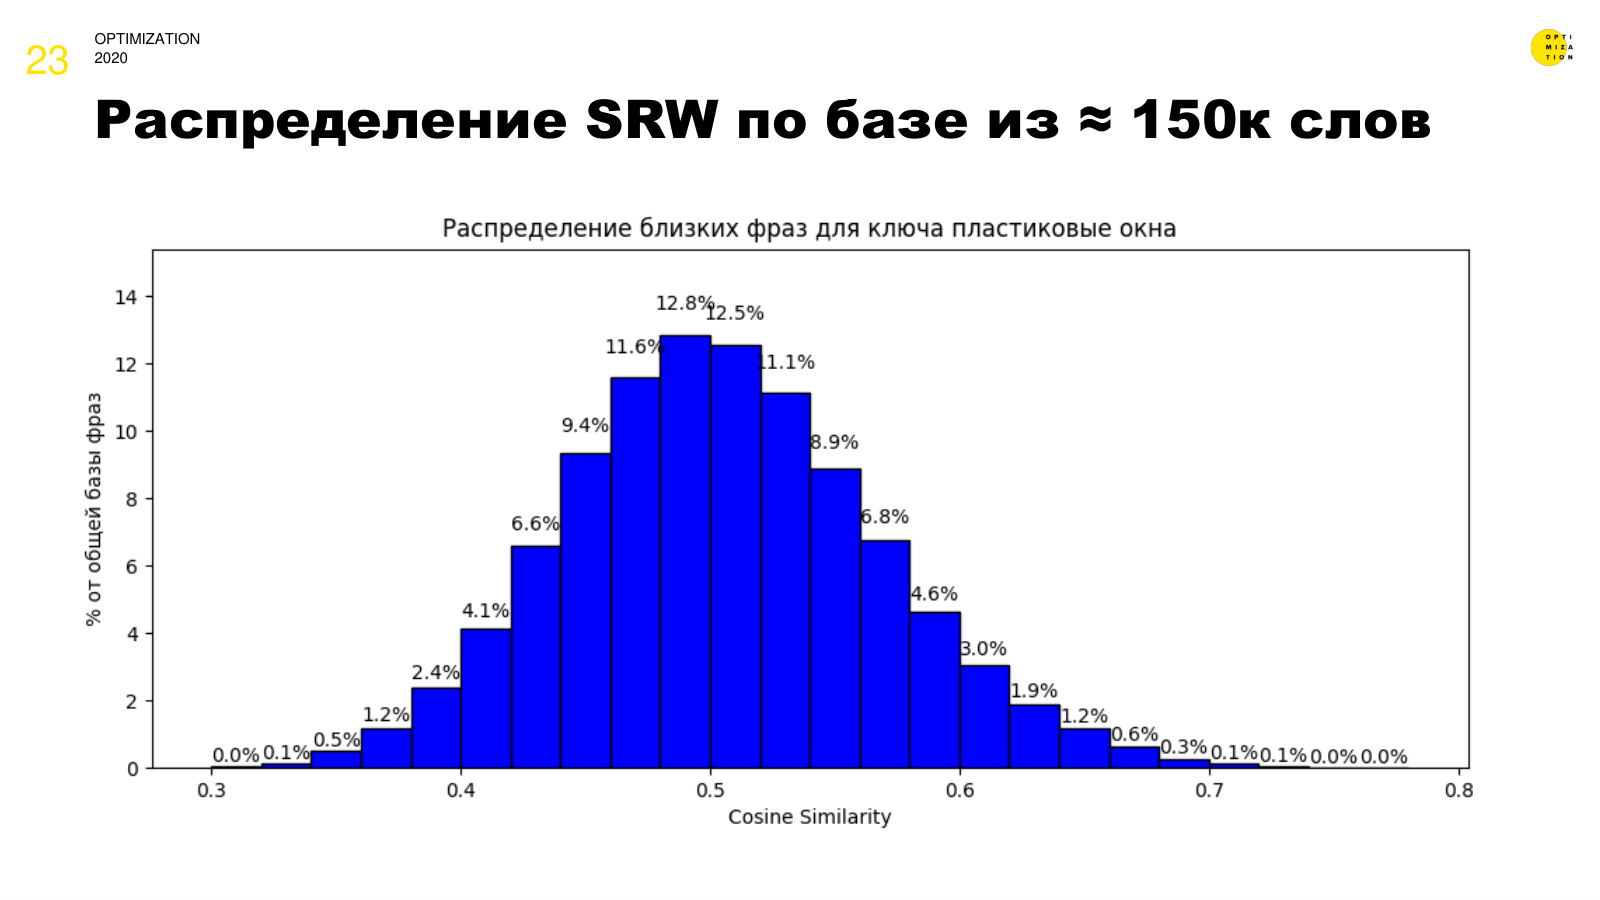
Для ключа «пластиковые окна» распределение косинусной близости по всей базе показывает: слова уровня «стеклопакет» с близостью 0,7 и выше — это менее 0,1% базы. Основная масса нейтральных слов держится в районе 0,5.
 Слайд 24 — есть ли порог отсечения
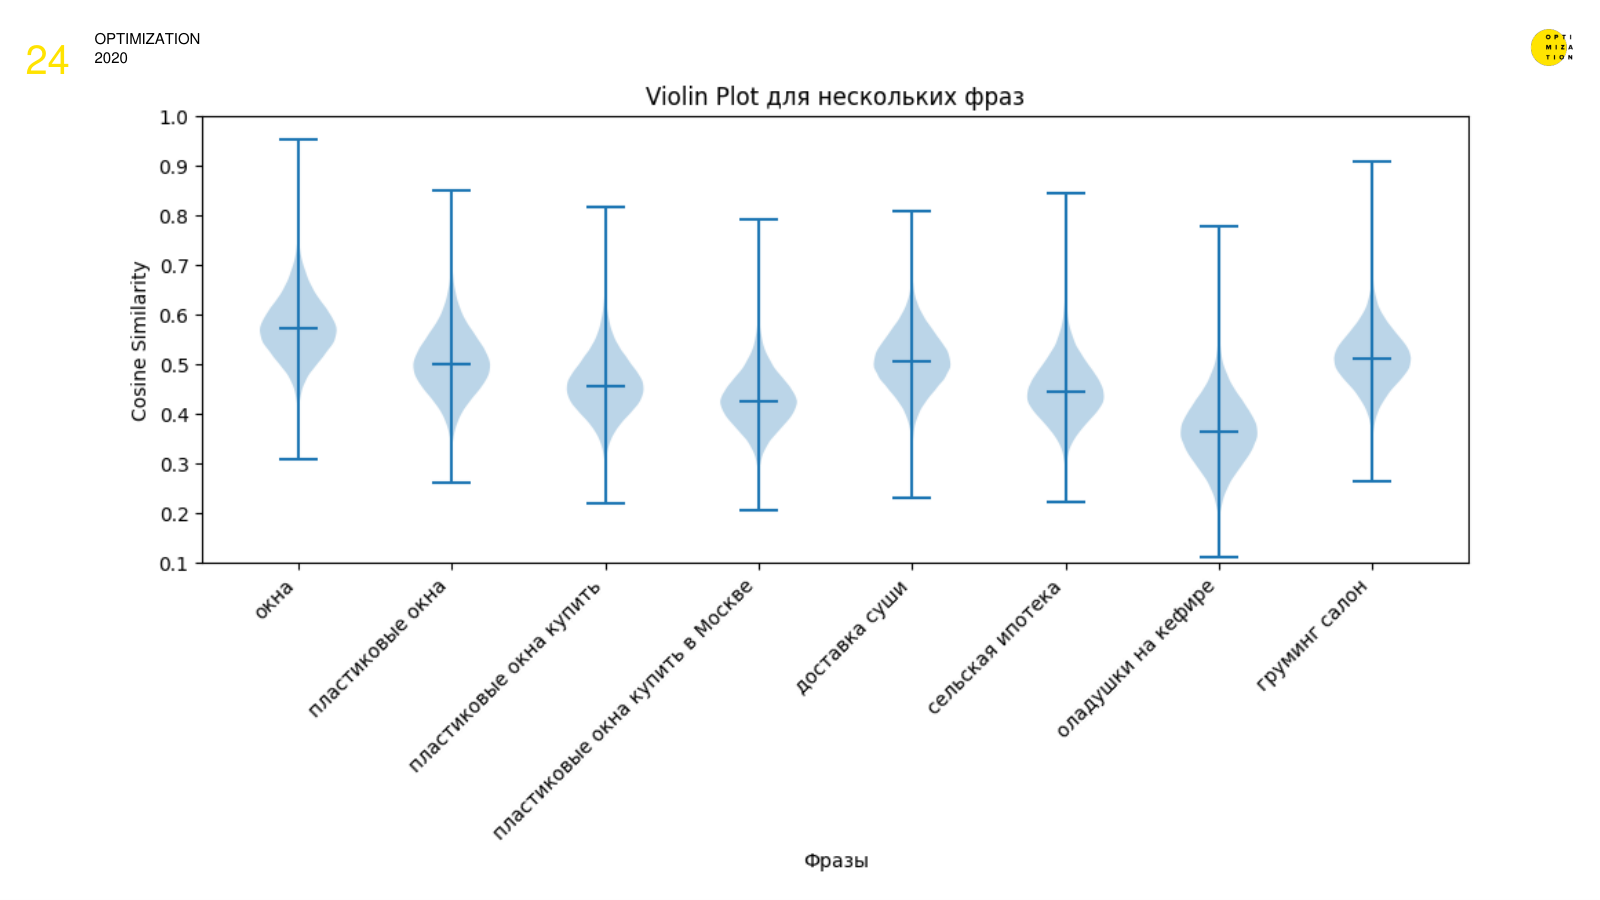
Сеошники любят конкретные пороги — как DR при покупке ссылок. Здесь такого порога нет: по графикам видно, что отсечение нужно смотреть индивидуально. Прослеживается некоторое смещение у двух- и трёхсловников, но оно в пределах статистической погрешности.
Методика эксперимента
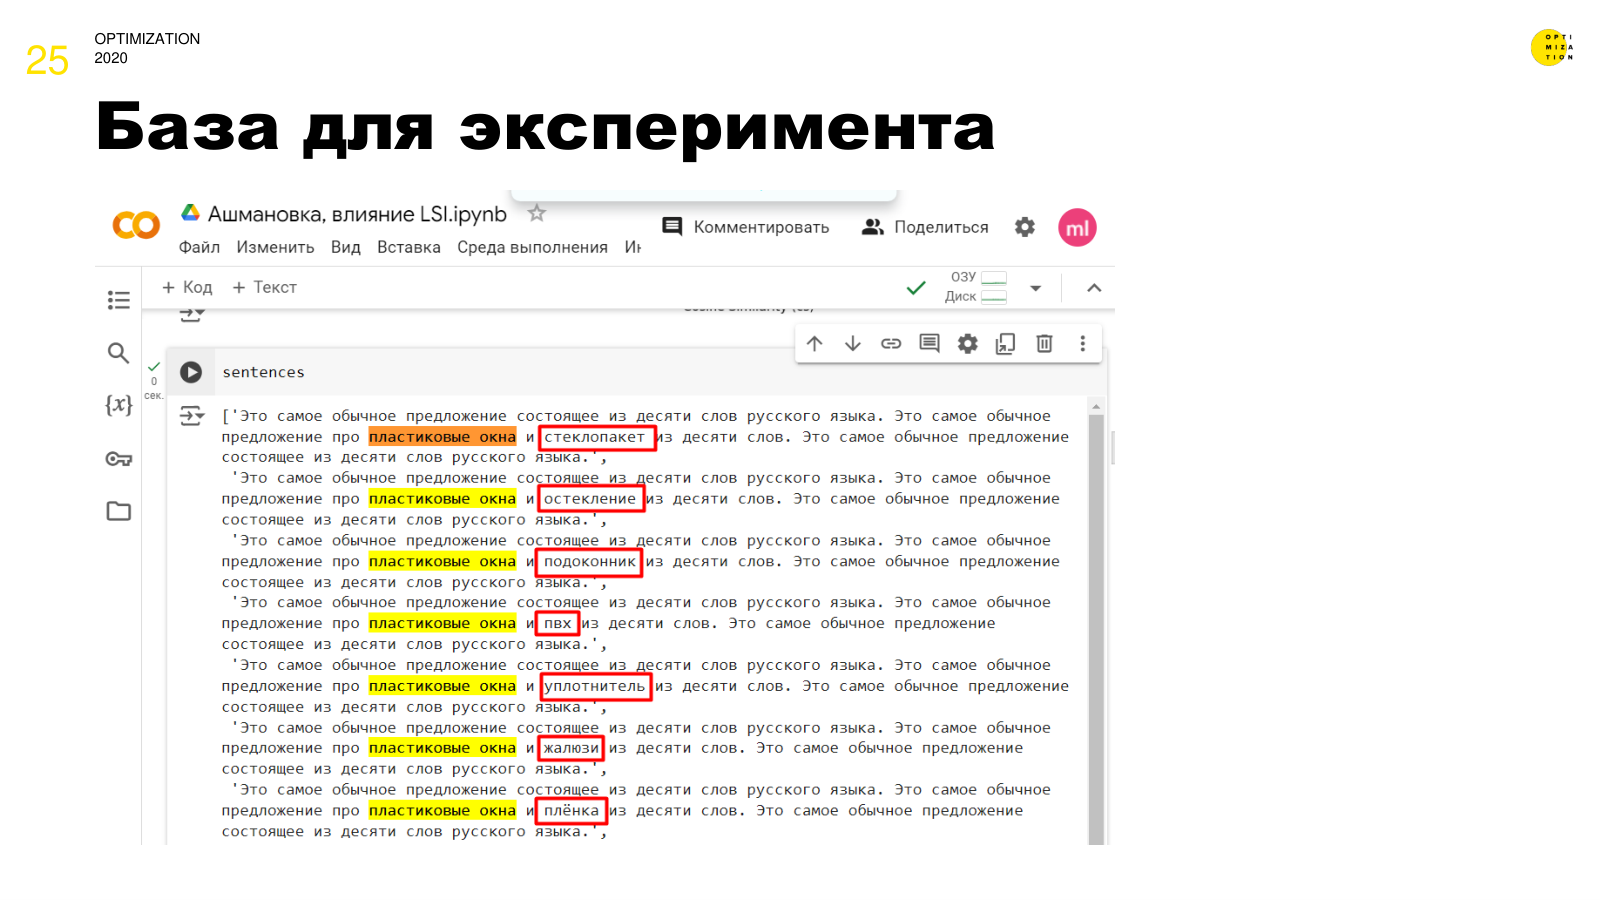 Слайд 25 — как собрана база
Берётся нейтральный текст слева и справа, в него добавляется ключ, а затем по очереди подставляются SRW-слова. Каждый раз считается косинусная близость пары «ключ» / «текст».
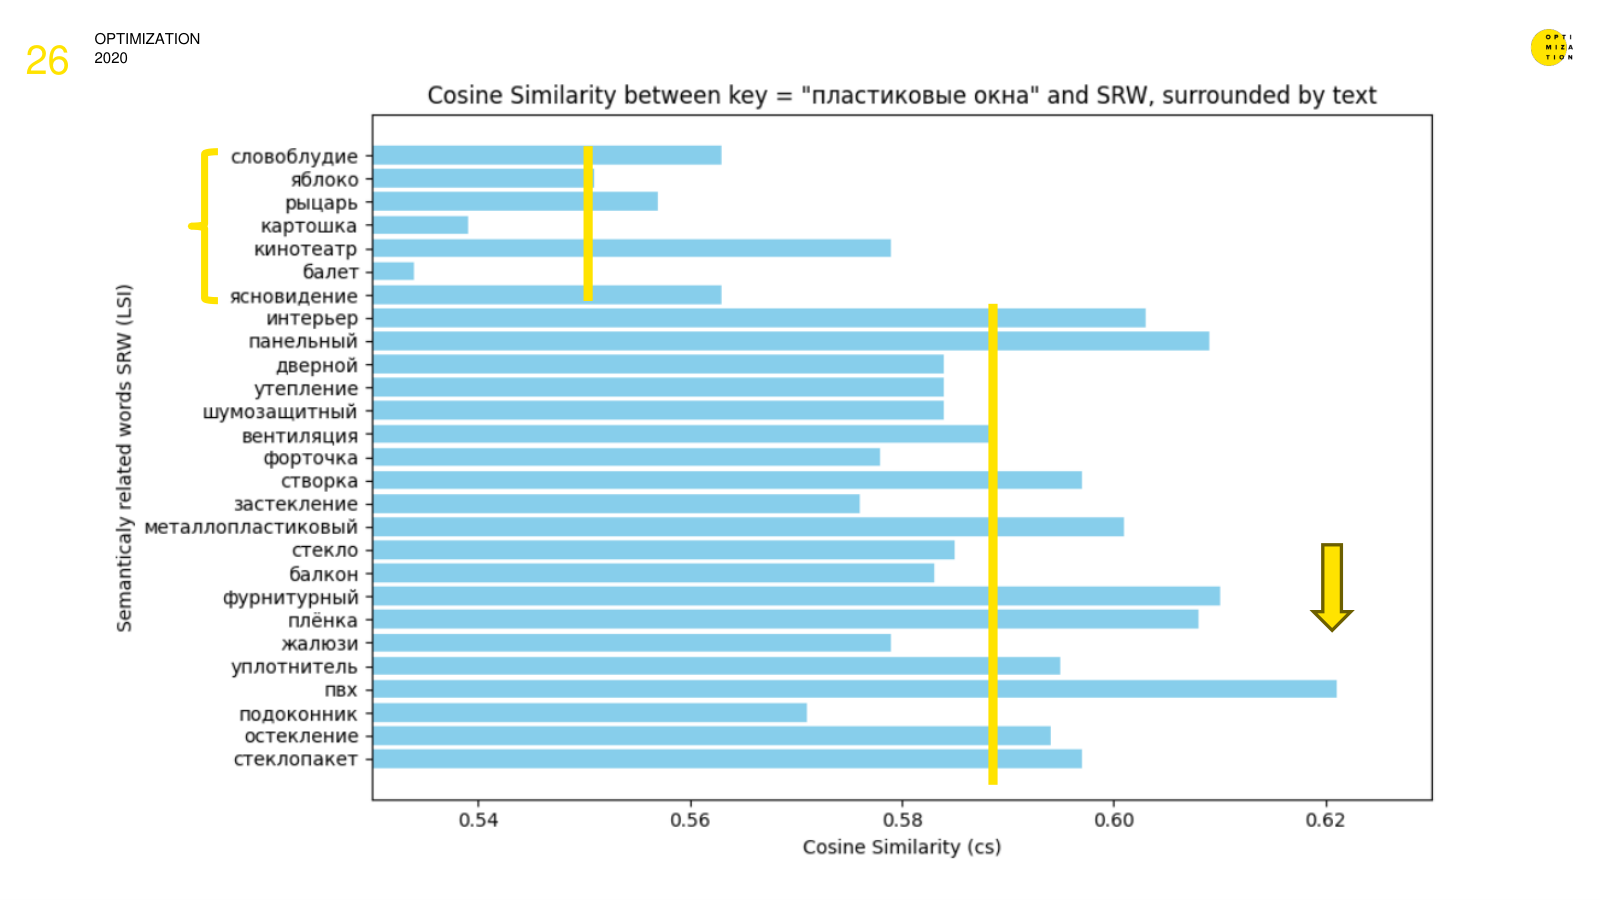 Слайд 26 — SRW в окружении текста, ключ «пластиковые окна»
Верхняя группа в скобках — заведомо нерелевантные слова: словоблудие, яблоко, рыцарь, картошка, кинотеатр, балет, ясновидение. Они держатся около 0,55. Нижняя группа — релевантные: подоконник, стеклопакет, ПВХ, фурнитурный, панельный, интерьер. Их медиана около 0,589, максимум — ПВХ с 0,621.
Тенденция есть, но разрыв невелик.
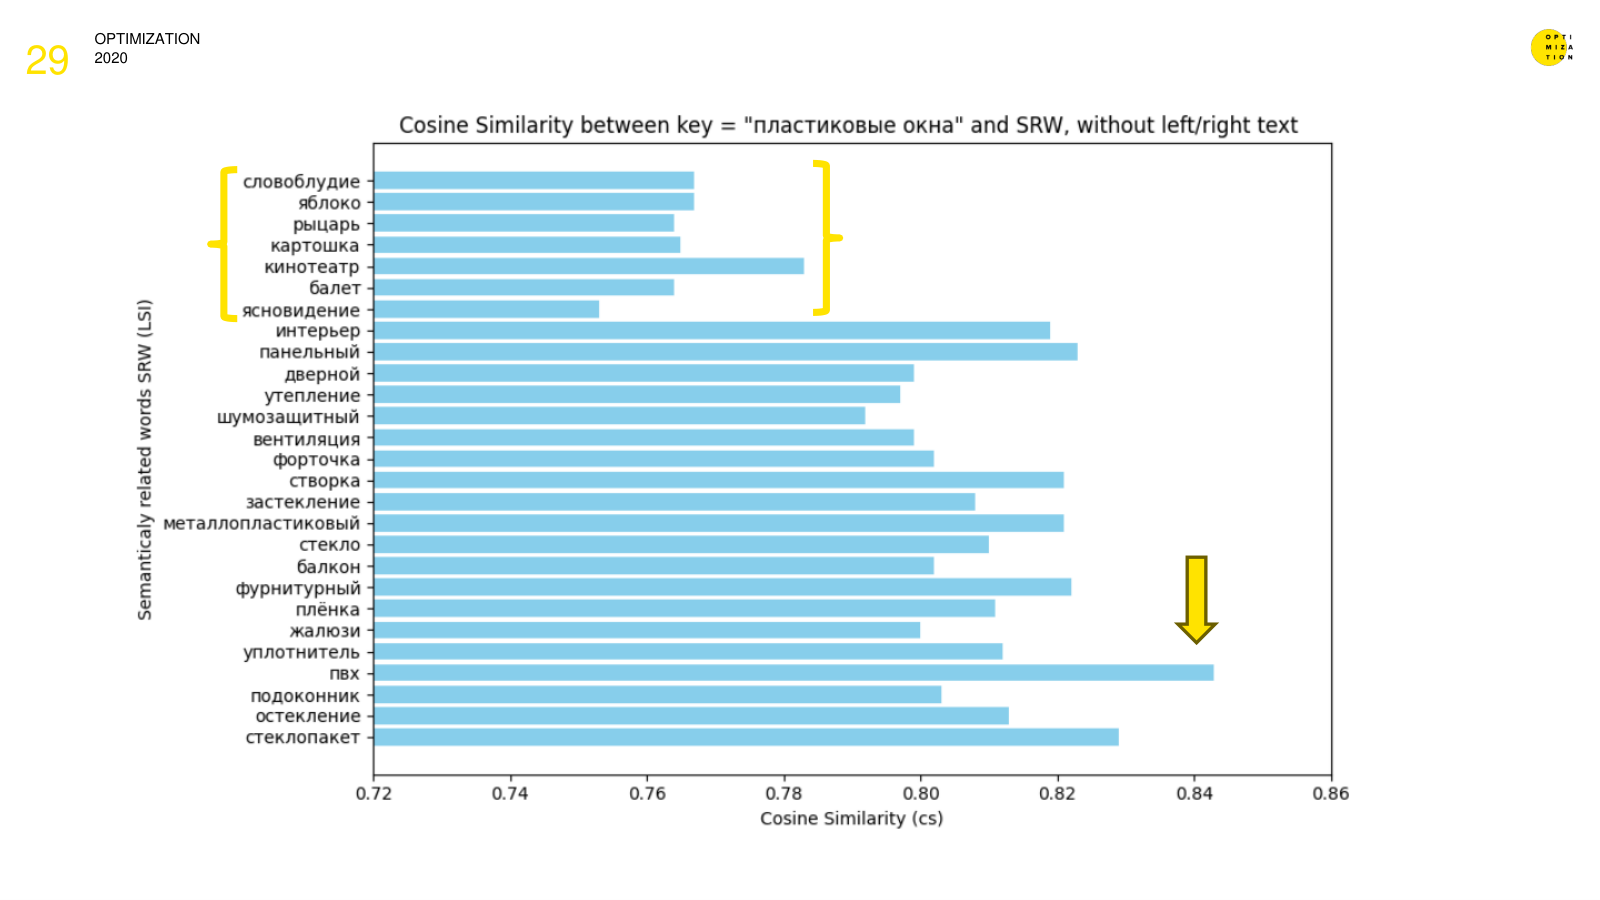 Слайд 29 — то же самое без текста слева и справа
Убираем шумящие предложения слева и справа, оставляем одно предложение. Картина становится гораздо отчётливее: нерелевантные слова около 0,75–0,78, релевантные — 0,79–0,84, ПВХ поднимается до 0,843 против 0,621 в предыдущем тесте.
Настолько сильно шумел окружающий текст.
Второе наблюдение из этого же графика: наиболее очевидно релевантное слово «стеклопакет» повлияло не сильнее прочих, а, например, «интерьер» дал заметный эффект. Предсказать, какое конкретно слово улучшит релевантность, невозможно.
Аналогичные прогоны сделаны для запросов «натяжные потолки», «доставка суши» и «груминг-салон». В случае с грумингом сильное влияние показало слово «корги».
Оговорка: это не строгое научное исследование — для него нужна репрезентативная выборка и статистика. Но в процессе подготовки доклада просмотрено порядка двух сотен таких картинок, и картина почти везде одинаковая. Если бы тенденции не было, эксперимент не попал бы в доклад.
Выводы эксперимента 1
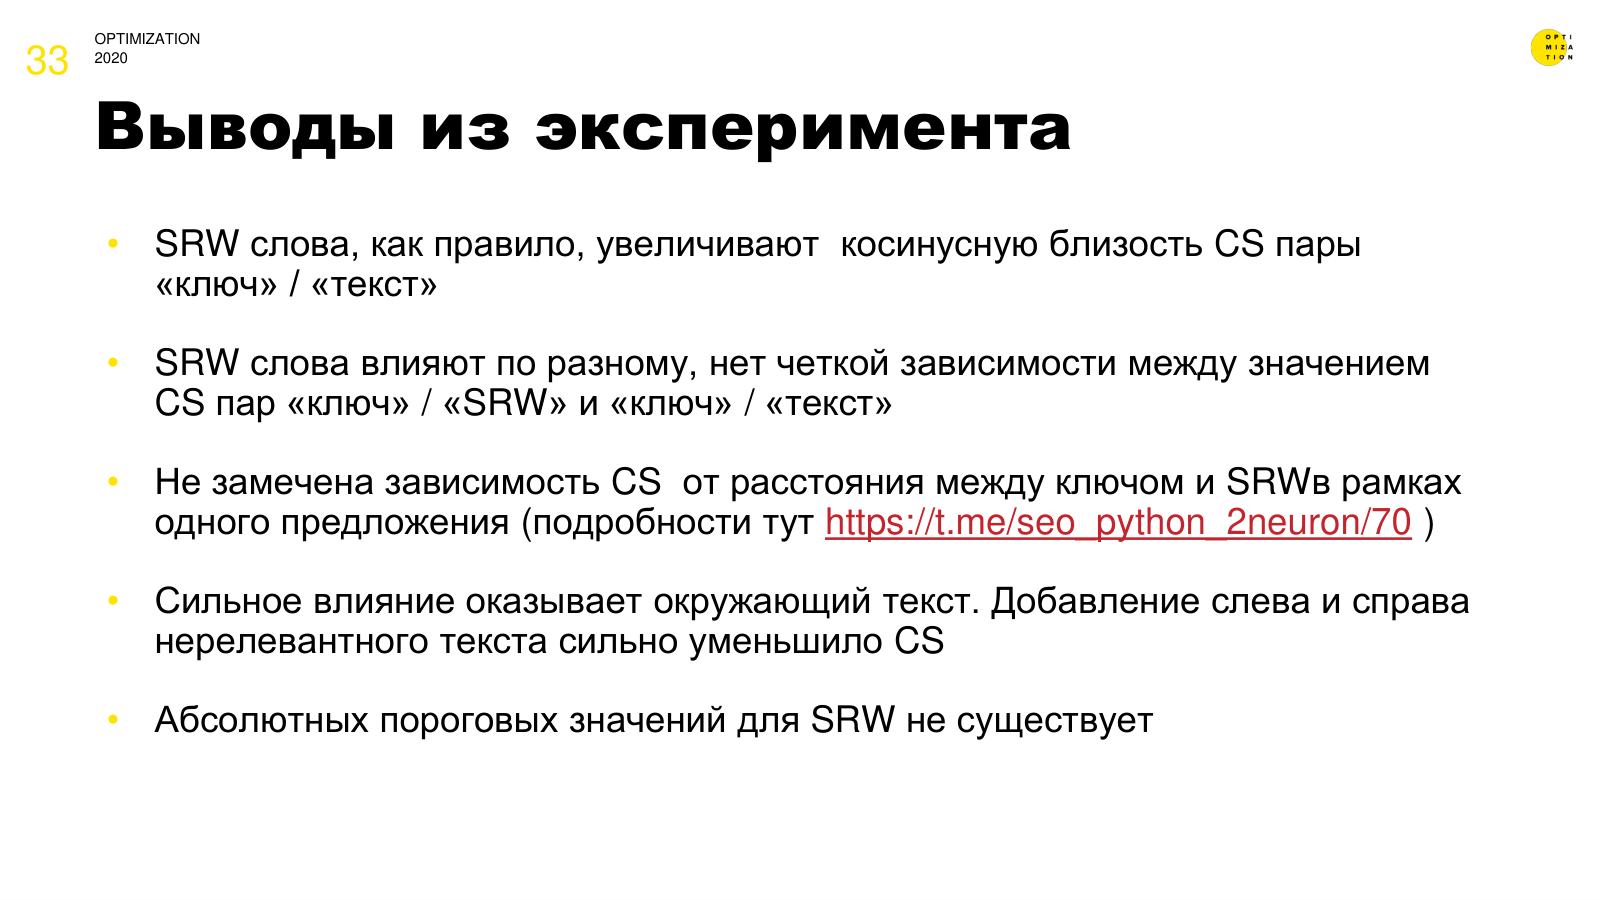 Слайд 33 — выводы
- SRW-слова, как правило, увеличивают косинусную близость пары «ключ» / «текст».
- SRW-слова влияют по-разному; чёткой зависимости между значением CS пары «ключ» / «SRW» и парой «ключ» / «текст» нет.
- Не обнаружена зависимость CS от расстояния между ключом и SRW в рамках одного предложения. Логично было бы предположить существование окна релевантности — условно 10 слов влево и вправо, и чем ближе к ключу, тем лучше. Этого не подтвердилось (подробности).
- Сильное влияние оказывает окружающий текст: добавление нерелевантного текста слева и справа резко уменьшает CS.
- Абсолютных пороговых значений для SRW не существует.
Эксперимент 2. Какая LLM лучше находит SRW
 Слайд 35 — как устроено сравнение
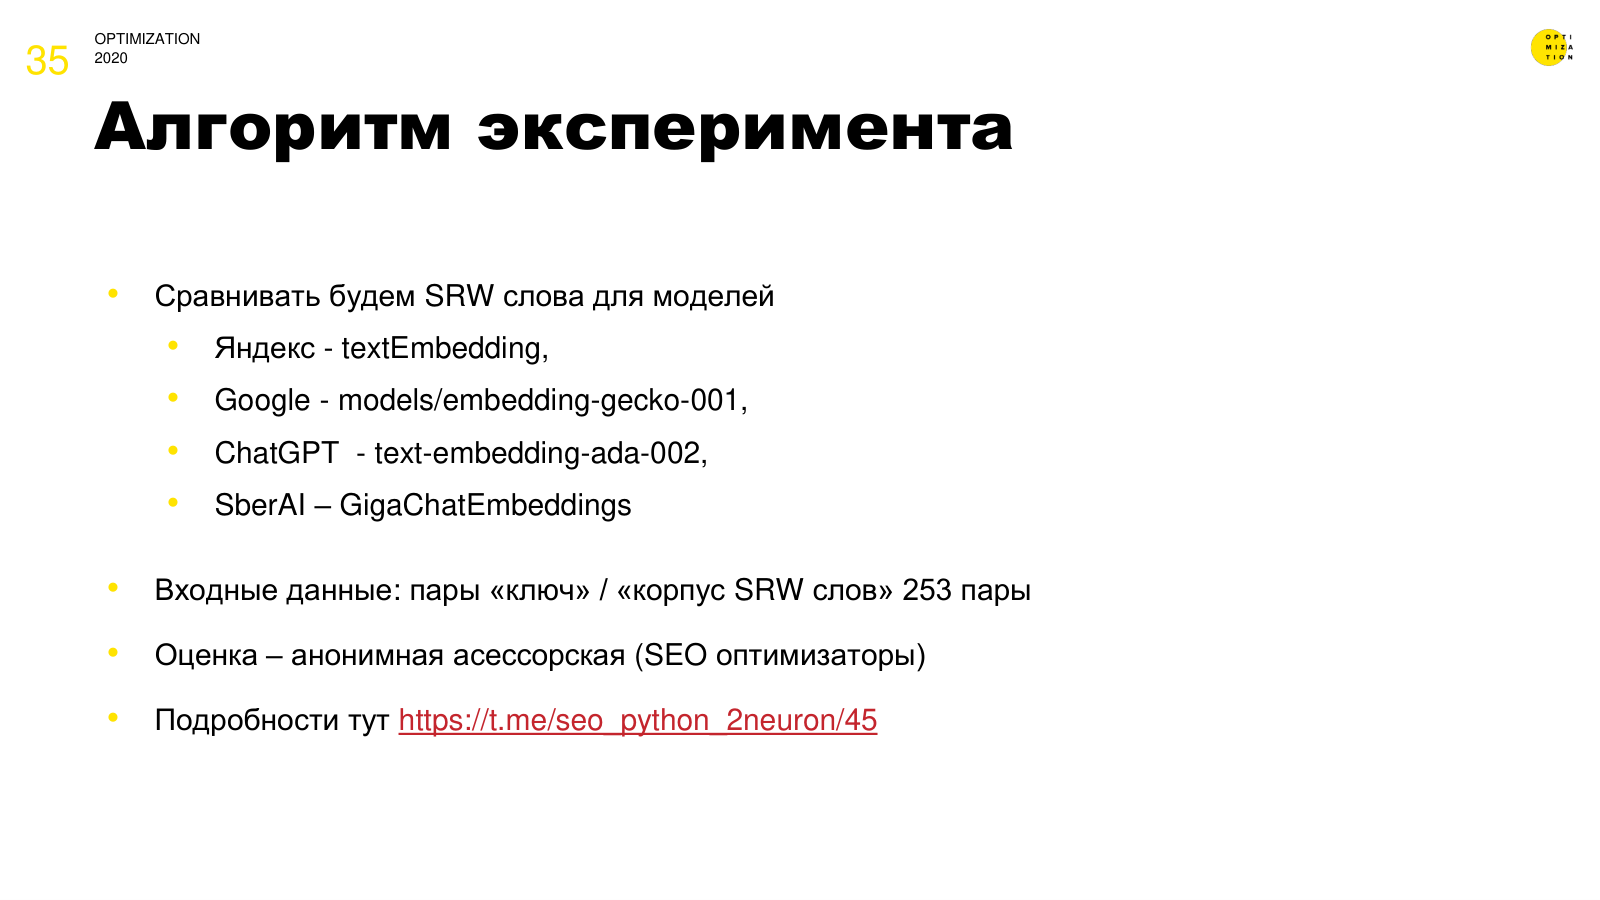
Сравниваются четыре модели: textEmbedding (Яндекс), text-embedding-ada-002 (ChatGPT), GigaChatEmbeddings (SberAI), models/embedding-gecko-001 (Google).
- Входные данные: 253 пары «ключ» / «корпус SRW-слов».
- Оценка: анонимная асессорская, оценивали практикующие SEO-специалисты — через телеграм-канал и по личным просьбам.
Асессору показывались списки SRW от четырёх моделей без указания, где какая, и он выбирал лучший (подробности).
 Слайд 37 — предварительные результаты
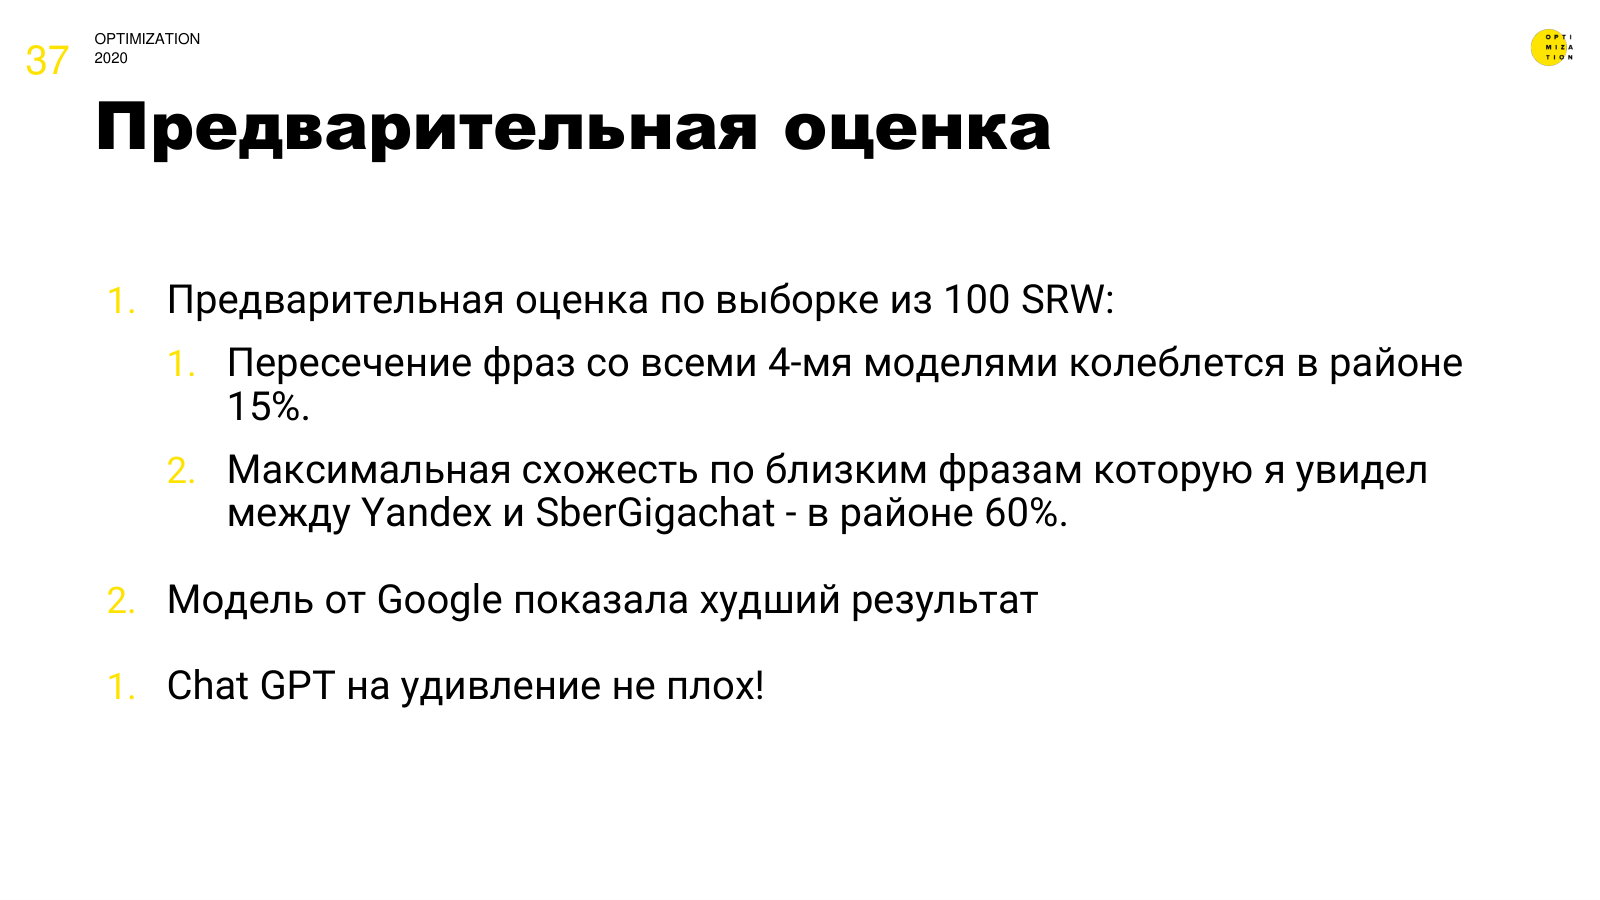
По выборке из 100 SRW:
- Пересечение фраз между всеми четырьмя моделями — около 15%. Это неожиданно мало: ожидалось 70–80%.
- Максимальная схожесть между двумя моделями — около 60%, у Яндекса и GigaChat. Объяснимо: обе русскоязычные.
- Модель Google показала худший результат.
- ChatGPT, на удивление, неплох.
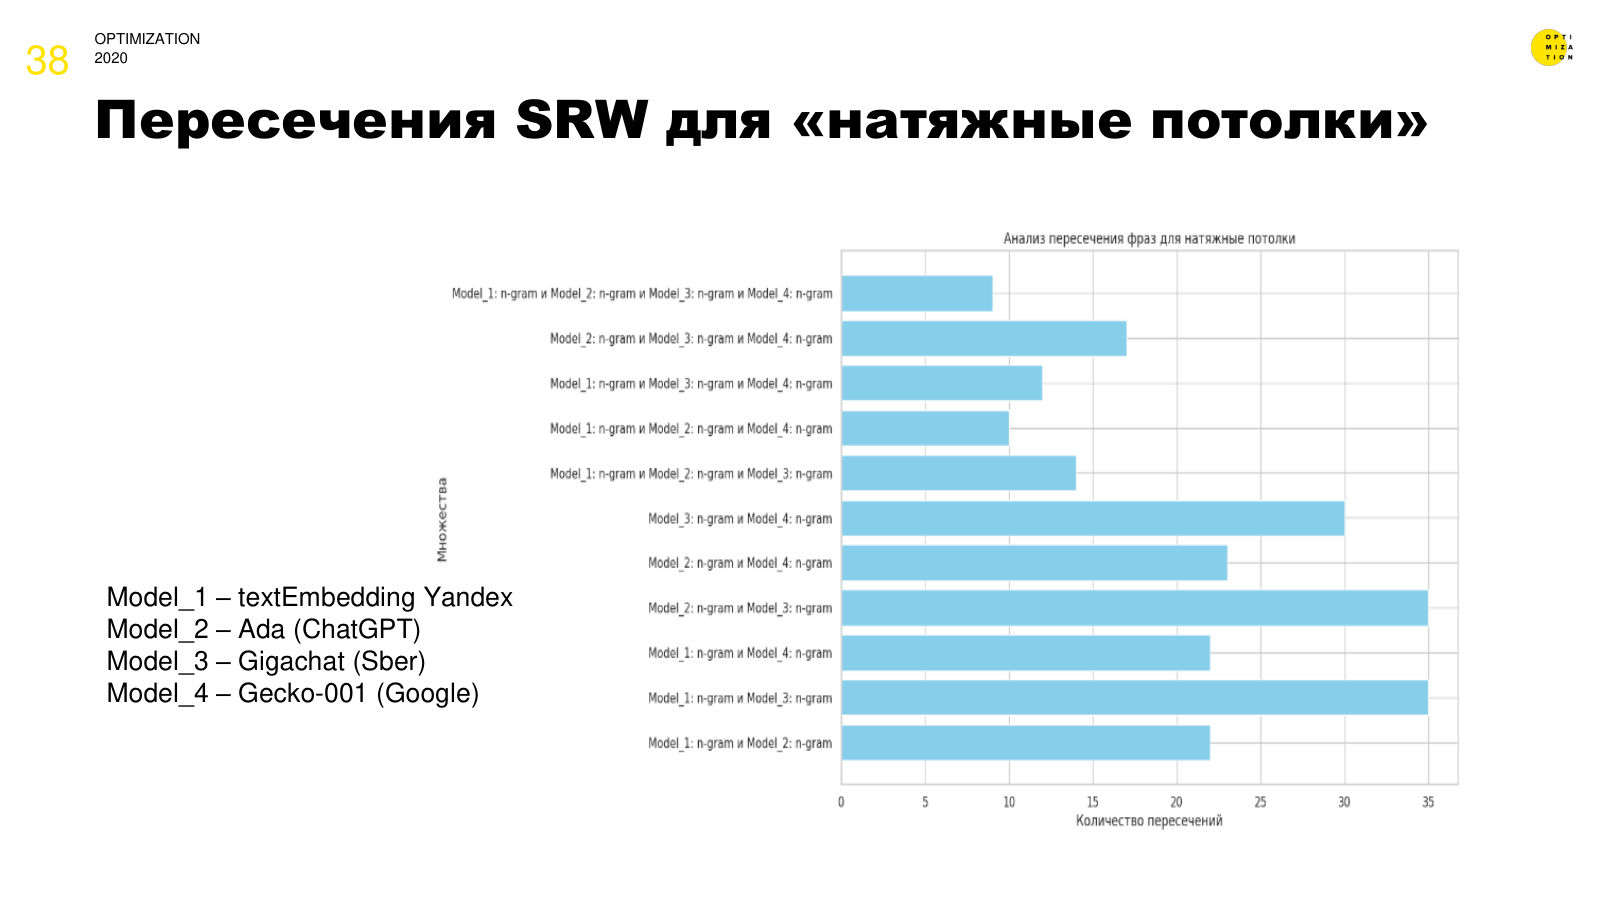 Слайд 38 — пересечения моделей по конкретной фразе
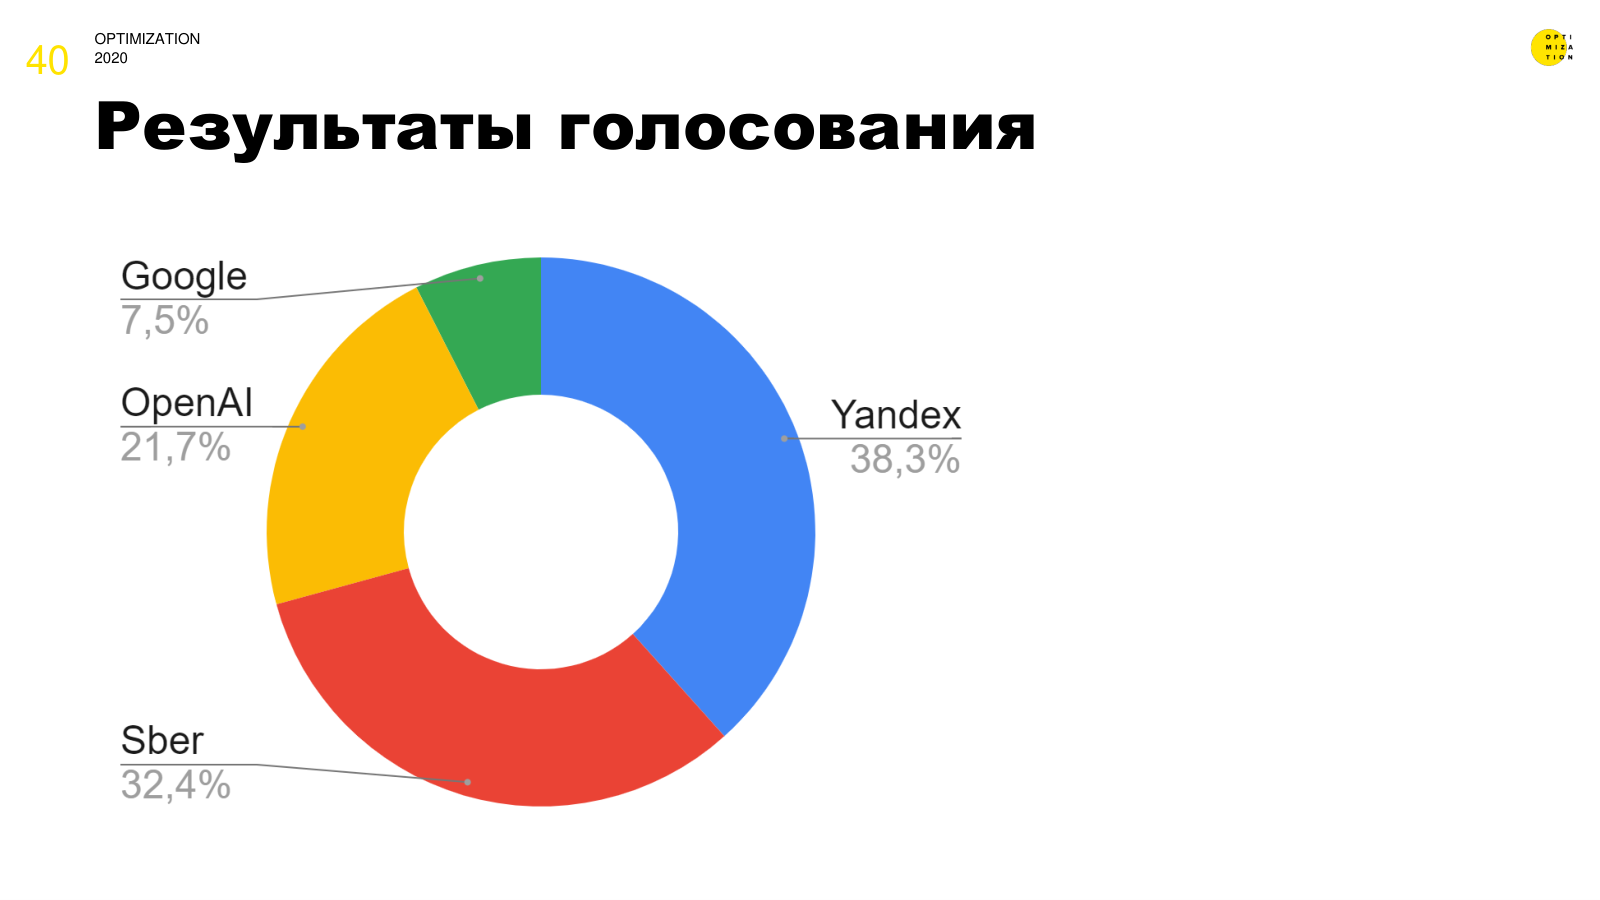 Слайд 40 — итоги асессорской оценки
| Модель | Доля голосов |
|---|---|
| Yandex (textEmbedding) | 38,3% |
| Sber (GigaChat) | 32,4% |
| OpenAI (ada) | 21,7% |
| Google (gecko-001) | 7,5% |
Фактически первое место стоит разделить между Яндексом и Сбером: примерно до середины эксперимента лидировал GigaChat, затем Яндекс его обошёл. При этом у GigaChat есть практическое преимущество — скорость. Модель Яндекса медленная, для полномасштабного эксперимента пришлось работать в десять потоков через несколько аккаунтов.
Итоговые выводы
 Слайд 41 — итоги доклада
- Текстовые факторы учитываются в ранжировании.
- SRW-слова можно вытащить напрямую из LLM-моделей.
- Добавление SRW-слов, как правило, увеличивает косинусную близость пары «ключ» / «текст».
- По мнению SEO-специалистов, лучше всего SRW находит модель textEmbedding от Яндекса.
- GigaChat и Яндекс дают самые близкие между собой результаты, Google — наименее похожие.
Ответы на вопросы
Что за база на 150–180 тысяч слов?
RusVectores, модель word2vec-ruscorpora-300.
Как быть с новыми нишами и другими языками — например, испанским, хинди или быстро меняющимися тематиками вроде крипты и трейдинга?
Модель Яндекса неплохо работает с иноязычными фразами — в клиентских базах встречаются и арабский, и испанский, и хинди. Показателен и случай ChatGPT: модель обучалась преимущественно на английском корпусе, по сути переводит на русский — и всё равно заняла второе место в голосовании.
Что до свежих данных: бот в любом случае идёт в выдачу. Он снимает сниппеты, находит URL, встречающиеся в ТОПе по большинству запросов кластера, выкачивает тексты и считает по ним. Если фразы нет в базе, обращение идёт напрямую к модели. Без выдачи задача не решается.
Почему в SRW попадают бренды и несуществующие слова?
Это не баг, а свойство трансформера. Трансформер — модель «энкодер-декодер»: он сжимает текст и разжимает обратно, по сути предугадывая продолжение. Благодаря накопленному опыту он способен соотнести с тематикой даже неологизм вроде выдуманного названия оконной компании, которого в базе нет. Тот же механизм заставляет генеративные модели дорисовывать изображение.
Классические подходы (BM25, IDF) упираются в актуальность базы. Почему прямое обращение к эмбеддингам решает эту проблему? Откуда уверенность, что в эмбеддингах то же самое, что в выдаче?
Тексты берутся не из головы, а с сайтов, которые находятся в ТОПе выдачи — они краулятся и анализируются. Кроме того, было отдельное исследование, где сравнивались разные текстовые анализаторы — Just Magic, SEOLemma, инструмент Артура Маркина — и все они показали плюс-минус одинаковые результаты.
Отдельно стоит сказать про классические инструменты: раньше все пользовались «Акварелью» Чекушина, и она отлично работала. Проблема в том, что ориентироваться по ТОПам стало сложно. Отсюда и возникла идея дёргать связи напрямую из модели.
Как составляются двух- и трёхсловные n-граммы?
Это и есть основная проблема. Перебрать все сочетания слов из базы в миллион слов невозможно. Поэтому путь один: идём в выдачу, достаём тексты сайтов из ТОПа и считаем биграммы и триграммы по ним.
А триграммы с перестановкой?
Эту тему я сознательно не затрагивал: цифры получаются разные, и можно ли на них ориентироваться — вопрос открытый. В рамках этого эксперимента такая задача не ставилась.
Материалы доклада: видео на YouTube · видео на VK · презентация
Инструмент из доклада: @vector_keywords_bot — поиск семантически релевантных n-грамм для ключевого слова и проверка их вхождений на странице.
Автор: Владислав Папернюк, агентство «Сайт-Активатор» · телеграм-канал Python SEO 2 нейрона