
Вайбкодинг: не дай себя побрить, как хомячка
Расшифровка вебинара. Номера слайдов соответствуют презентации.
Идея этого вебинара родилась из одного вопроса. В сообществе курса ученица написала: «Мы реально стали эффективнее. Мы внедряем скрипты, внедряем автоматизации, делаем то, что раньше делали десять сеошников. А мы стали богаче? А мы стали свободнее?»
Вопрос зацепил, потому что ответ неочевиден. Сейчас не вайбкодит только ленивый: кого ни спроси — все с горящими глазами рассказывают, что поставили Claude, поставили Codex и работают эффективнее. При этом деньги те же, а времени, кажется, стало уходить больше.
Дальше — разбор того, как AI-эйфория превращается в минус по финмодели, и что нужно построить вместо этого.
Почему все вдруг бросились вайбкодить
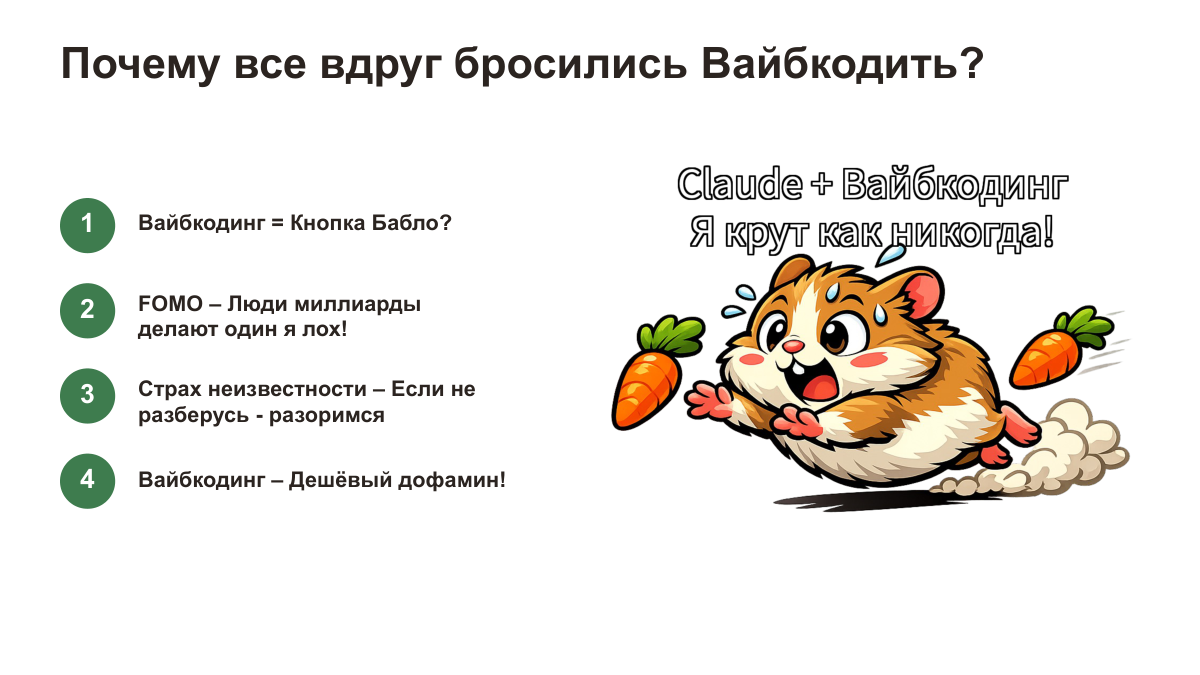 Слайд 3 — четыре причины
1. Вайбкодинг = кнопка «бабло»? Перед сеошниками в очередной раз забрезжила знаменитая большая красная кнопка. Раньше это были поведенческие факторы, потом PBN — теперь вайбкодинг. Кажется, что всё просто: ставишь агента, он работает всю ночь, а ты лежишь под пальмой и считаешь поступления.
2. FOMO — «люди миллиарды делают, один я лох». Очередная новость о школьниках, навайбкодивших сервис на миллион долларов, бьёт по больному.
3. Страх неизвестности — «если не разберусь, разоримся». Многие руководители агентств в состоянии лёгкой паники: рынок SEO сокращается, денег становится меньше, все переходят на вайбкодинг. Разместите вакансию SEO-специалиста — набежит толпа, какой раньше не было. Отсюда ощущение, что нужно срочно вливаться.
4. Вайбкодинг — дешёвый дофамин. Для кого-то дешёвый дофамин — сериал или спортзал. Здесь — открыл ноутбук, написал три промпта, получил готовый отчёт и почувствовал себя нереально крутым. Anthropic и OpenAI нашли идеальную целевую аудиторию: маркетологов, сеошников, креаторов.
Кто реально зарабатывает
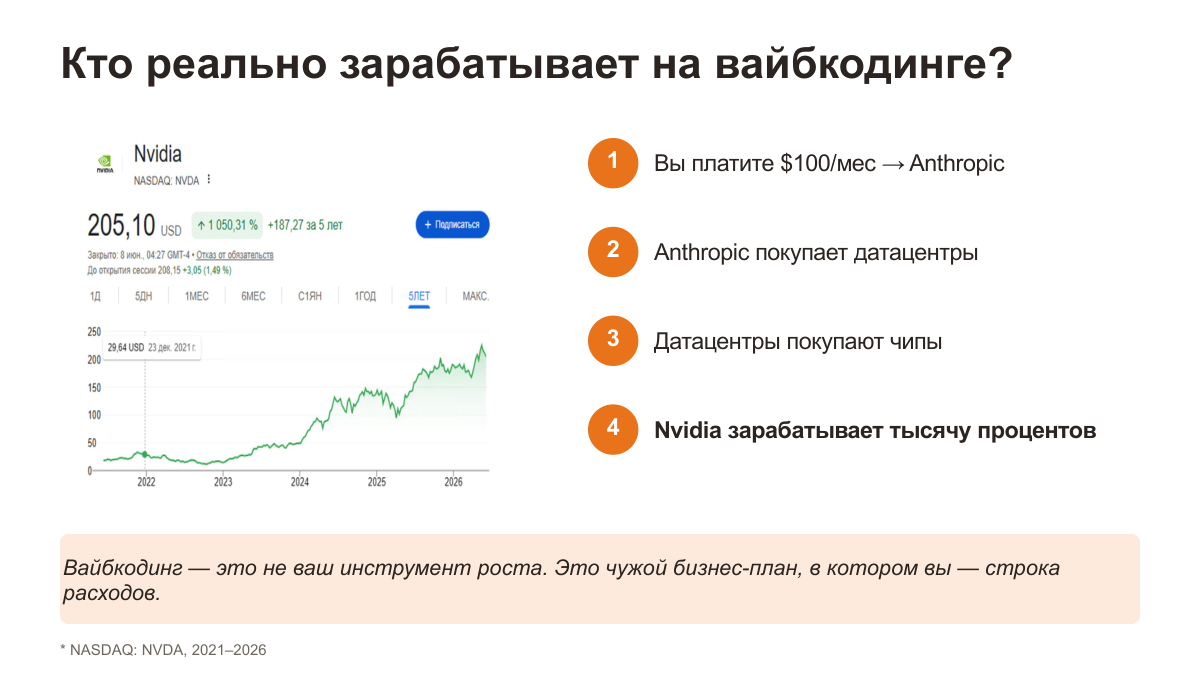 Слайд 4 — цепочка денег
- Вы платите $100 в месяц → Anthropic.
- Anthropic покупает датацентры.
- Датацентры покупают чипы.
- Nvidia зарабатывает тысячу процентов.
Вайбкодинг — это не ваш инструмент роста. Это чужой бизнес-план, в котором вы строка расходов.
 Слайд 5 — что говорят про вайбкодинг
«За ночь сделал 500 агентов». «Уволил половину команды и забрал разницу». «Купил курс, получил прибыль ×2». «Собрал себе второй мозг».
Вы смотрите на рекламу. Реклама всегда показывает морковку — но никогда колесо, в котором бежит хомячок.
Финансовая модель: ожидание
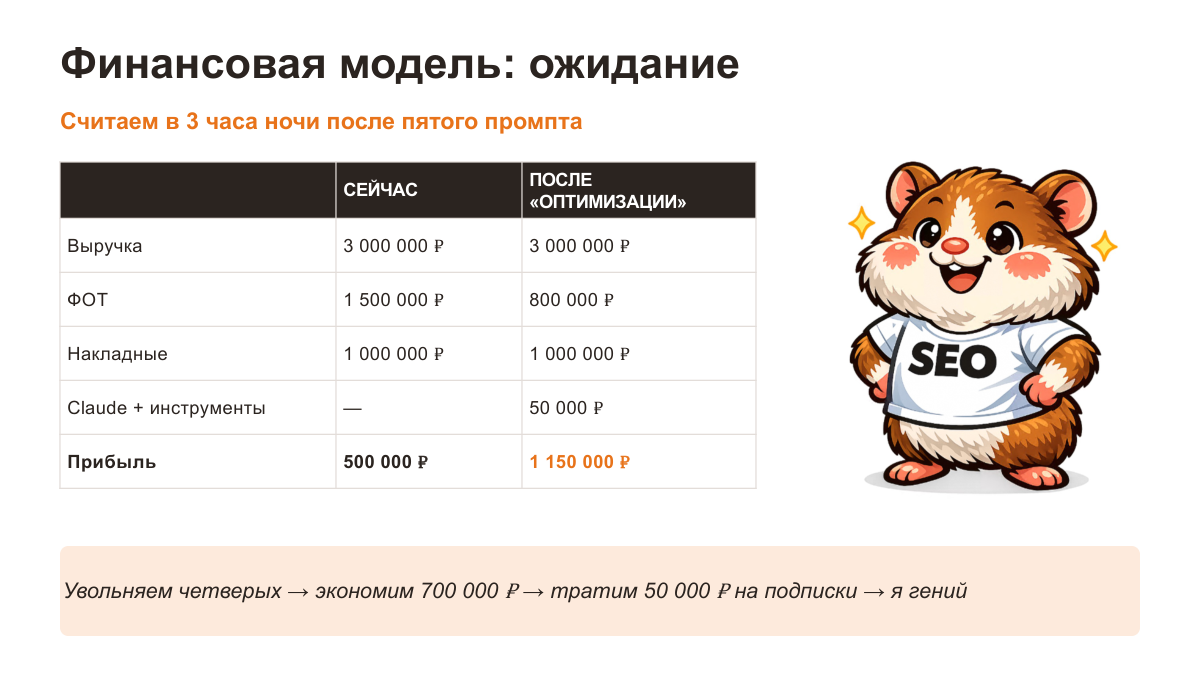 Слайд 6 — расчёт в три часа ночи после пятого промпта
Возьмём небольшое агентство и посчитаем, как считает его собственник, вдохновившись идеей автоматизации.
| Сейчас | После «оптимизации» | |
|---|---|---|
| Выручка | 3 000 000 ₽ | 3 000 000 ₽ |
| ФОТ | 1 500 000 ₽ | 800 000 ₽ |
| Накладные | 1 000 000 ₽ | 1 000 000 ₽ |
| Claude + инструменты | — | 50 000 ₽ |
| Прибыль | 500 000 ₽ | 1 150 000 ₽ |
Логика железная: увольняем четверых, экономим 700 тысяч, тратим 50 тысяч на подписки — я гений. Прибыль ×2 одним действием.
Финансовая модель: реальность
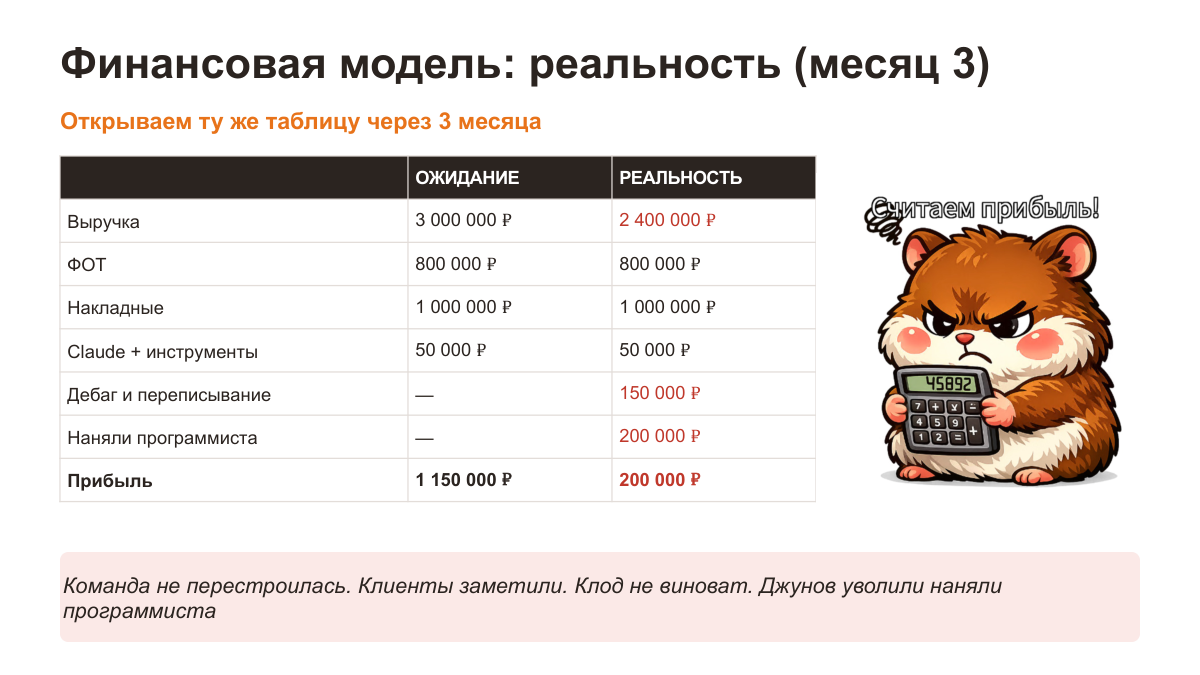 Слайд 7 — та же таблица через три месяца
| Ожидание | Реальность | |
|---|---|---|
| Выручка | 3 000 000 ₽ | 2 400 000 ₽ |
| ФОТ | 800 000 ₽ | 800 000 ₽ |
| Накладные | 1 000 000 ₽ | 1 000 000 ₽ |
| Claude + инструменты | 50 000 ₽ | 50 000 ₽ |
| Дебаг и переписывание | — | 150 000 ₽ |
| Наняли программиста | — | 200 000 ₽ |
| Прибыль | 1 150 000 ₽ | 200 000 ₽ |
Что произошло. Выручка просела, потому что половину команды уволили, какие-то ИИ-решения внедрили, но качество упало и клиенты начали уходить. Появились затраты, о которых никто не предупреждал: автоматизации сделаны криво и сумбурно, их приходится постоянно чинить. К концу третьего месяца пришлось нанять программиста, которого раньше в штате не было.
Команда не перестроилась. Клиенты заметили. Claude не виноват.
Ловушка KPI на внедрение нейросетей
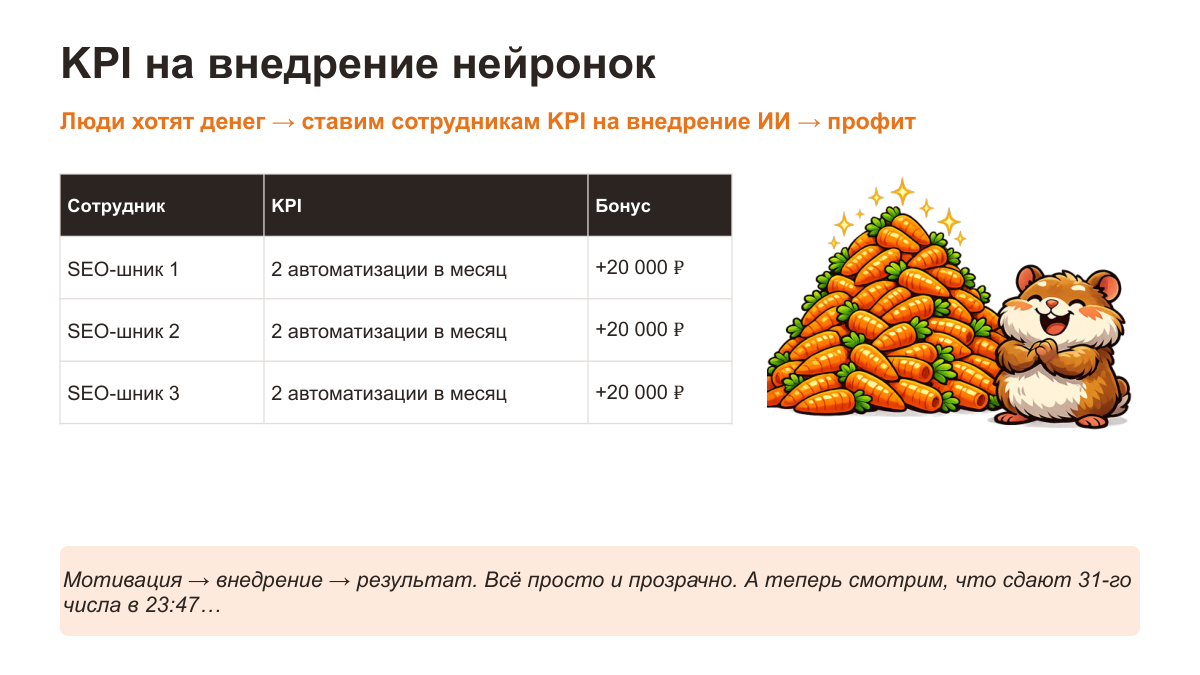 Слайд 8 — мотивация через KPI
Следующий шаг собственника выглядит логично: команда саботирует внедрение — значит, нужно её заинтересовать. Каждому специалисту ставится KPI: две автоматизации в месяц, бонус +20 000 ₽.
Это не выдуманная схема — так действительно работает одно из агентств, руководителя которого я знаю.
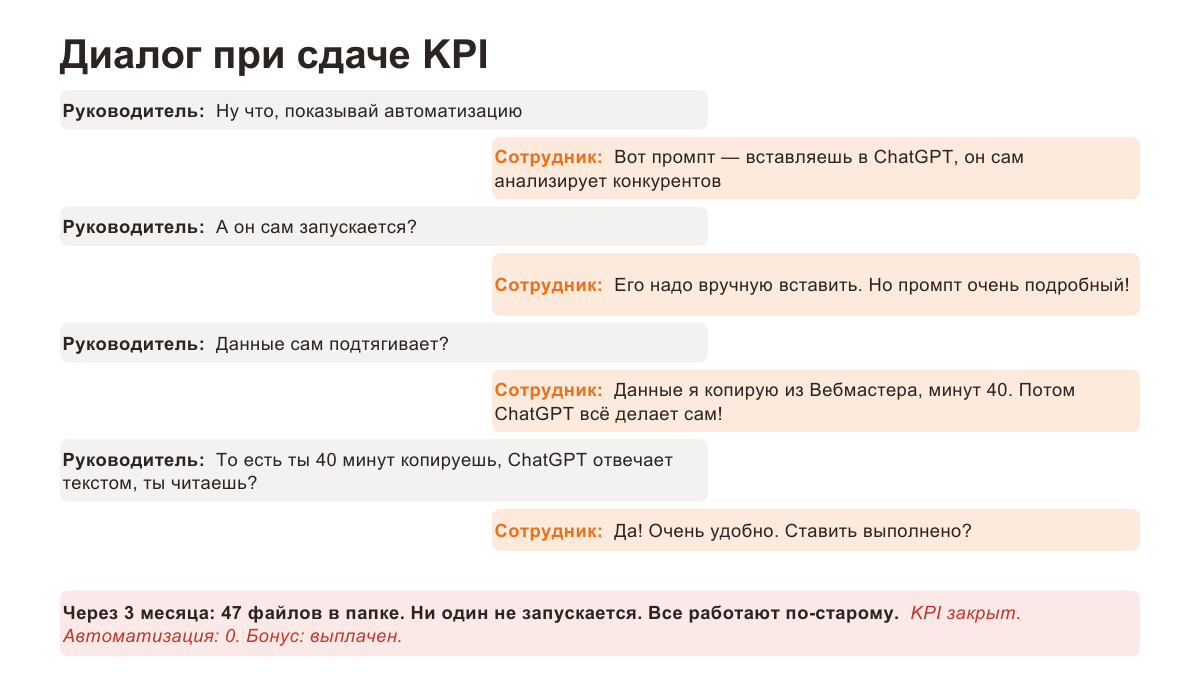 Слайд 9 — что сдают 31-го числа в 23:47
— Ну что, показывай автоматизацию. — Вот промпт: вставляешь в ChatGPT, он сам анализирует конкурентов. — А он сам запускается? — Его надо вручную вставить. Но промпт очень подробный! — Данные сам подтягивает? — Данные я копирую из Вебмастера, минут 40. Потом ChatGPT всё делает сам! — То есть ты 40 минут копируешь, ChatGPT отвечает текстом, ты читаешь? — Да! Очень удобно. Ставить «выполнено»?
Через три месяца: 47 файлов в папке, ни один не запускается, все работают по-старому. KPI закрыт, автоматизация нулевая, бонус выплачен.
Похожую историю я проходил сам, примерно тремя годами ранее. Сотруднице был поставлен KPI на профессиональный рост: подготовить роадмап обучения на полгода. Все запросы к ChatGPT тогда шли через корпоративного Telegram-бота — и сотрудники не знали, что переписка видна руководителю. В логах обнаружился запрос: «Слушай, с меня шеф требует какую-то фигню, составь мне, пожалуйста, вот это». С сотрудницей пришлось расстаться — но вопрос «а внедряется ли что-то на самом деле» с тех пор остаётся открытым.
Вопросы, на которые нет ответов
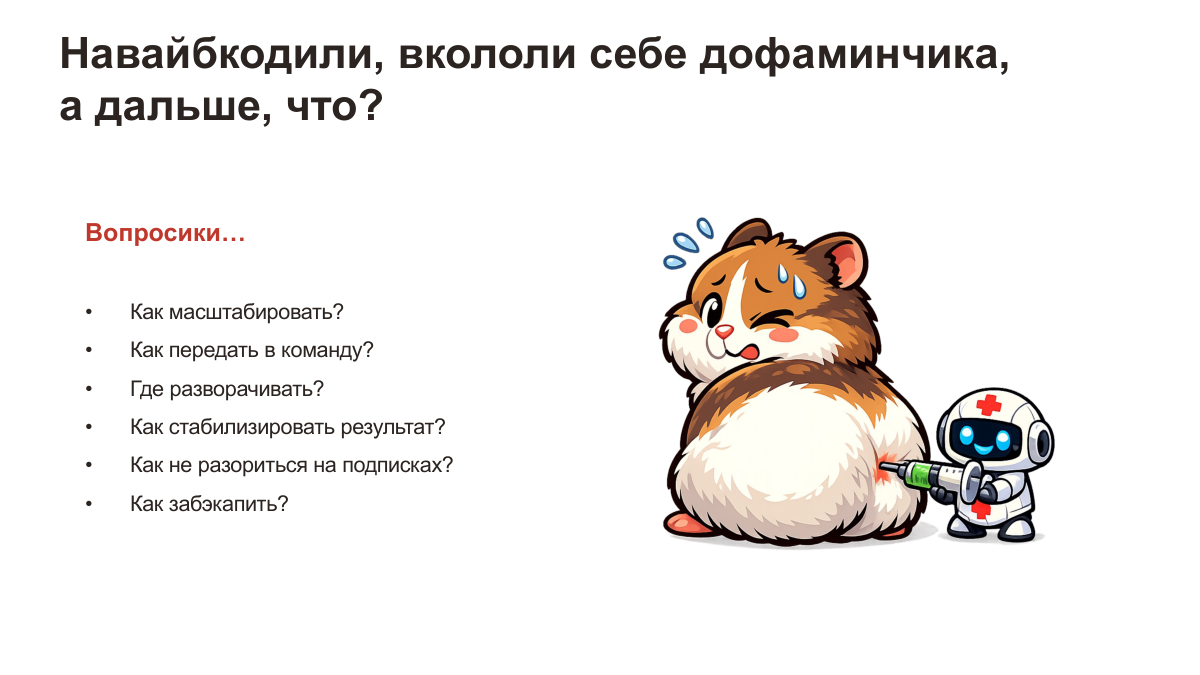 Слайд 10 — а дальше что?
Дофамин вколот, автоматизация навайбкожена. Дальше начинаются вопросы:
- Как масштабировать?
- Как передать в команду?
- Где разворачивать?
- Как стабилизировать результат?
- Как не разориться на подписках?
- Как забэкапить?
Это не теория. Разговор с крупным известным агентством в день вебинара свёлся ровно к этому: «Мы что-то сделали, что-то поставили, но проблема в системности и в масштабировании». Один специалист может навайбкодить себе инструмент. Вопрос в том, как развернуть это на команду. Каждому покупать Claude? Тогда упираемся в баны российских аккаунтов и вечную игру в кошки-мышки. Не Claude — тогда что? Где это хранить, на чём разворачивать панель, как стабилизировать результат?
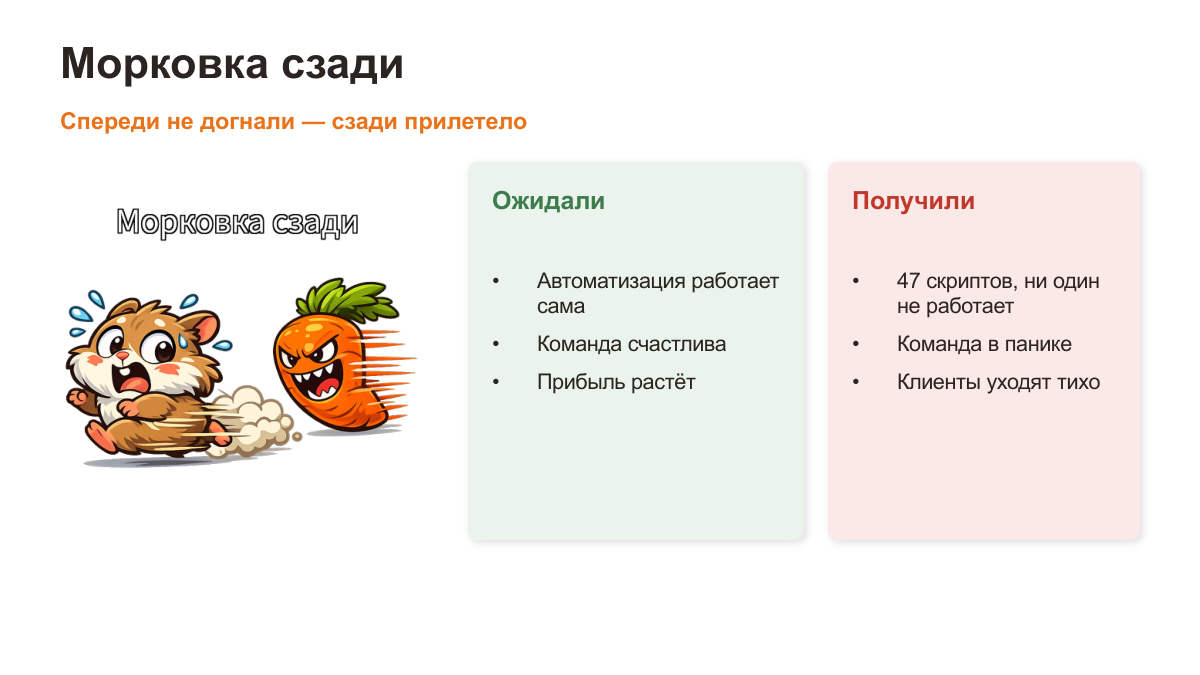 Слайд 11 — спереди не догнали, сзади прилетело
Ожидали: автоматизация работает сама, команда счастлива, прибыль растёт. Получили: 47 скриптов, ни один не работает, команда в панике, клиенты уходят тихо.
Факап № 1. Кладбище автоматизаций
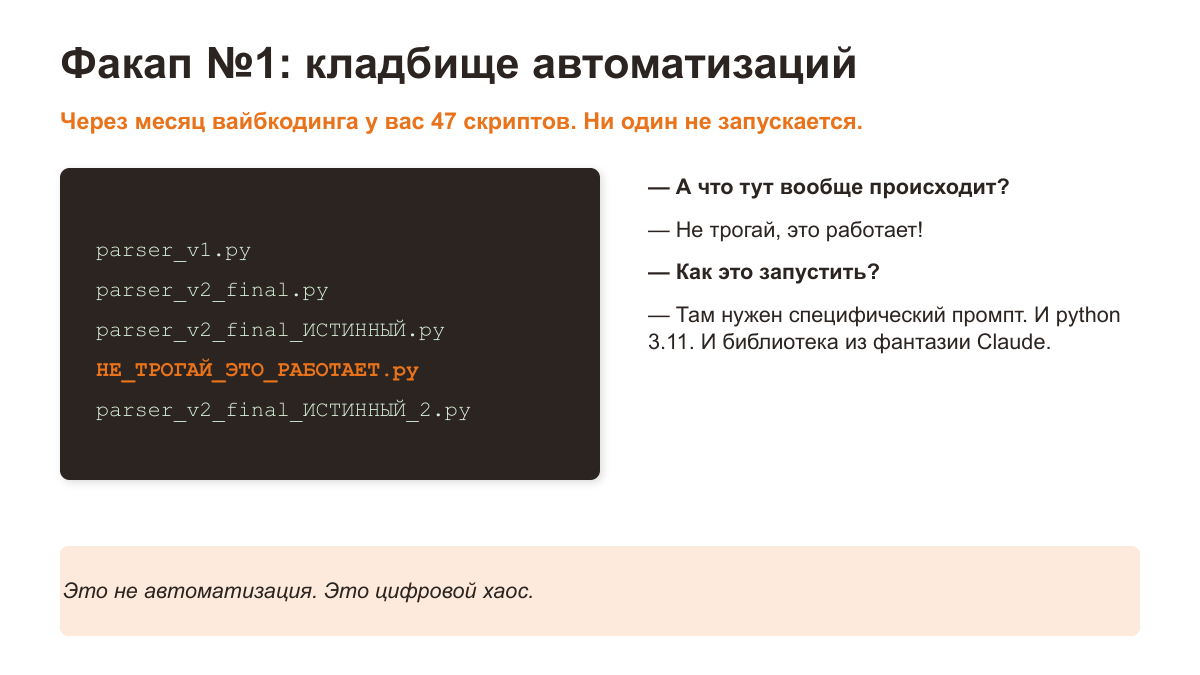 Слайд 12 — цифровой хаос
parser_v1.py
parser_v2_final.py
parser_v2_final_ИСТИННЫЙ.py
НЕ_ТРОГАЙ_ЭТО_РАБОТАЕТ.py
parser_v2_final_ИСТИННЫЙ_2.py
— А что тут вообще происходит? — Не трогай, это работает! — Как это запустить? — Там нужен специфический промпт. И Python 3.11. И библиотека из фантазии Claude.
Забавная деталь: этот слайд сгенерировал сам Claude Code — и почти угадал, как я вайбкодил собственные сервисы два-три года назад. Там было ровно так же: «финал», «последний», «дата истины».
Это не автоматизация. Это цифровой хаос.
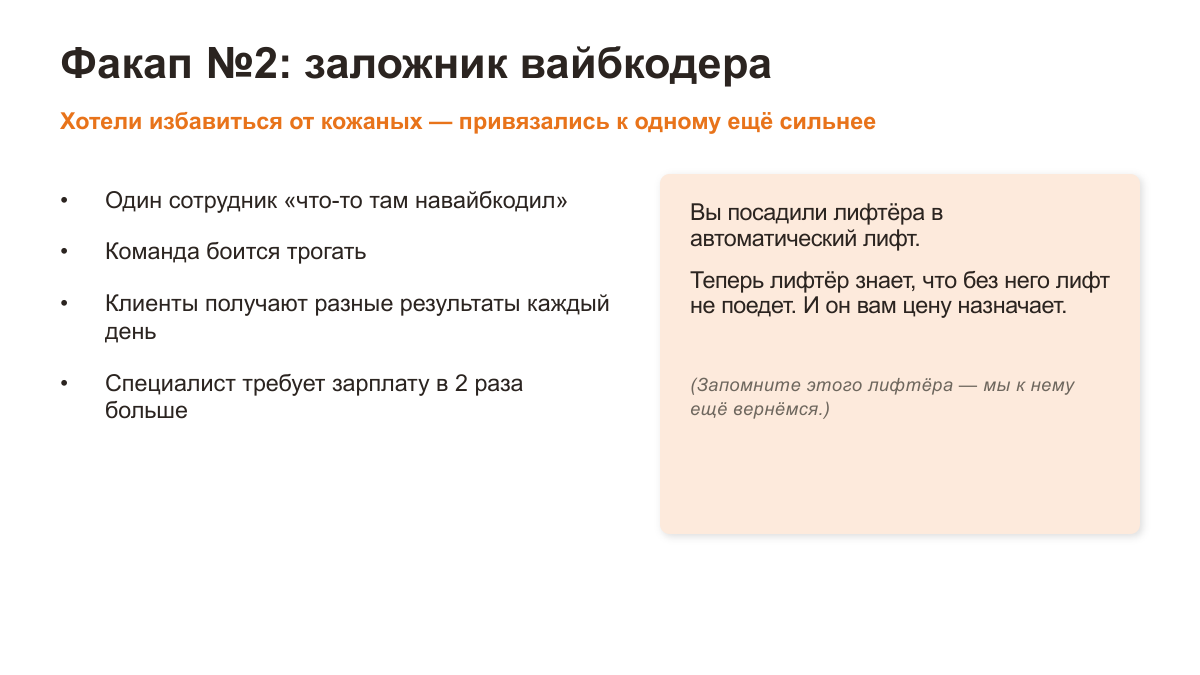
Факап № 2. Заложник вайбкодера
 Слайд 13 — привязались к одному человеку ещё сильнее
- Один сотрудник «что-то там навайбкодил».
- Команда боится трогать.
- Клиенты получают разные результаты каждый день.
- Специалист требует зарплату в два раза больше.
Вы посадили лифтёра в автоматический лифт. Теперь лифтёр знает, что без него лифт не поедет, и назначает цену.
Проблема не в человеке, а в отсутствии документации и стандарта. Если один специалист навайбкодил и уволился — как передать это команде, непонятно. Разгребать придётся нанятому программисту.
Факап № 3. Галлюцинации на продакшене
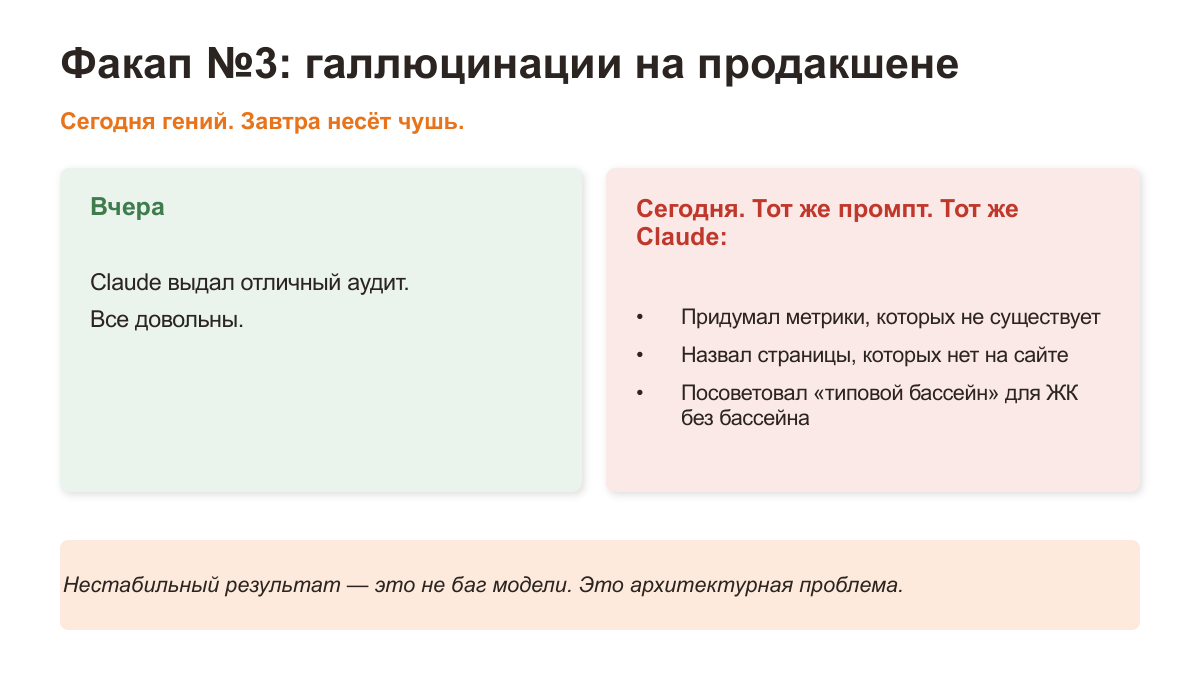 Слайд 14 — сегодня гений, завтра несёт чушь
Вчера Claude выдал отличный аудит, все довольны. Сегодня тот же промпт и тот же Claude:
- придумал метрики, которых не существует;
- назвал страницы, которых нет на сайте;
- посоветовал «типовой бассейн» для ЖК без бассейна.
Нестабильный результат — это не баг модели. Это архитектурная проблема.
Занавес
 Слайд 15 — три акта
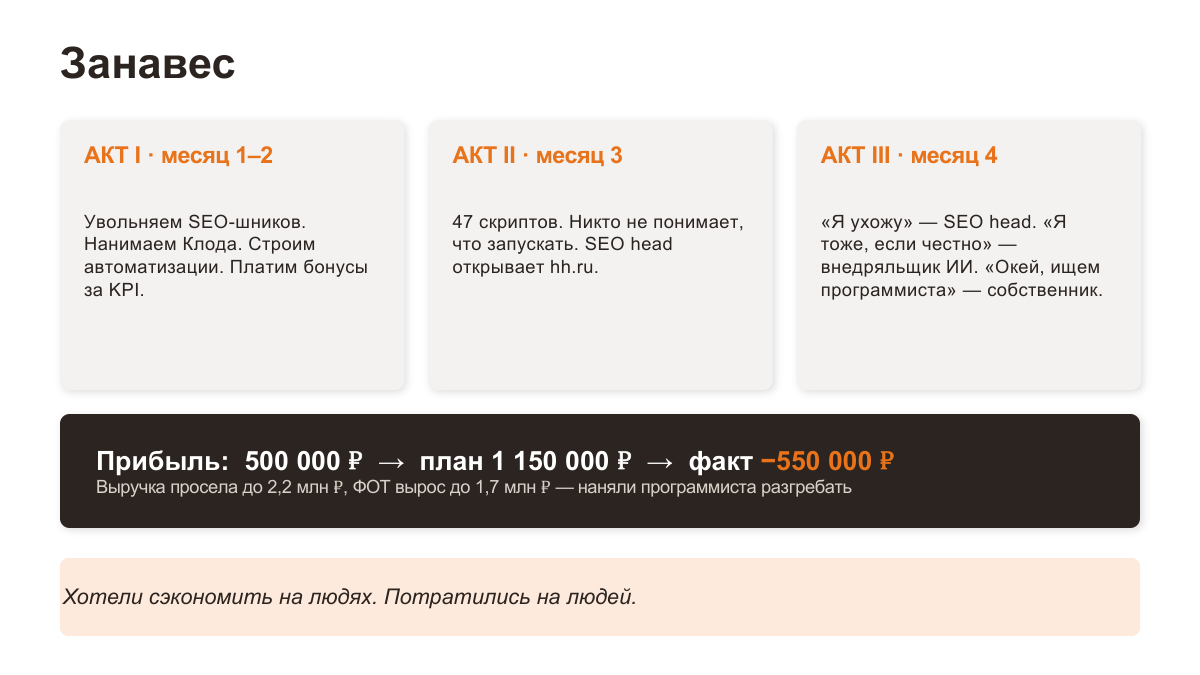
Акт I, месяцы 1–2. Увольняем сеошников. Нанимаем Claude. Строим автоматизации. Платим бонусы за KPI.
Акт II, месяц 3. 47 скриптов, никто не понимает, что запускать. SEO Head открывает hh.ru.
Акт III, месяц 4. «Я ухожу» — SEO Head. «Я тоже, если честно» — внедряльщик ИИ. «Окей, ищем программиста» — собственник.
Прибыль: было 500 000 ₽ → план 1 150 000 ₽ → факт −550 000 ₽. Выручка просела до 2,2 млн, ФОТ вырос до 1,7 млн — наняли программиста разгребать.
Хотели сэкономить на людях — потратились на людей.
Вывод: не торопитесь экономить на людях, пока не выстроены процессы.
 Слайд 16 — старая кабала против новой
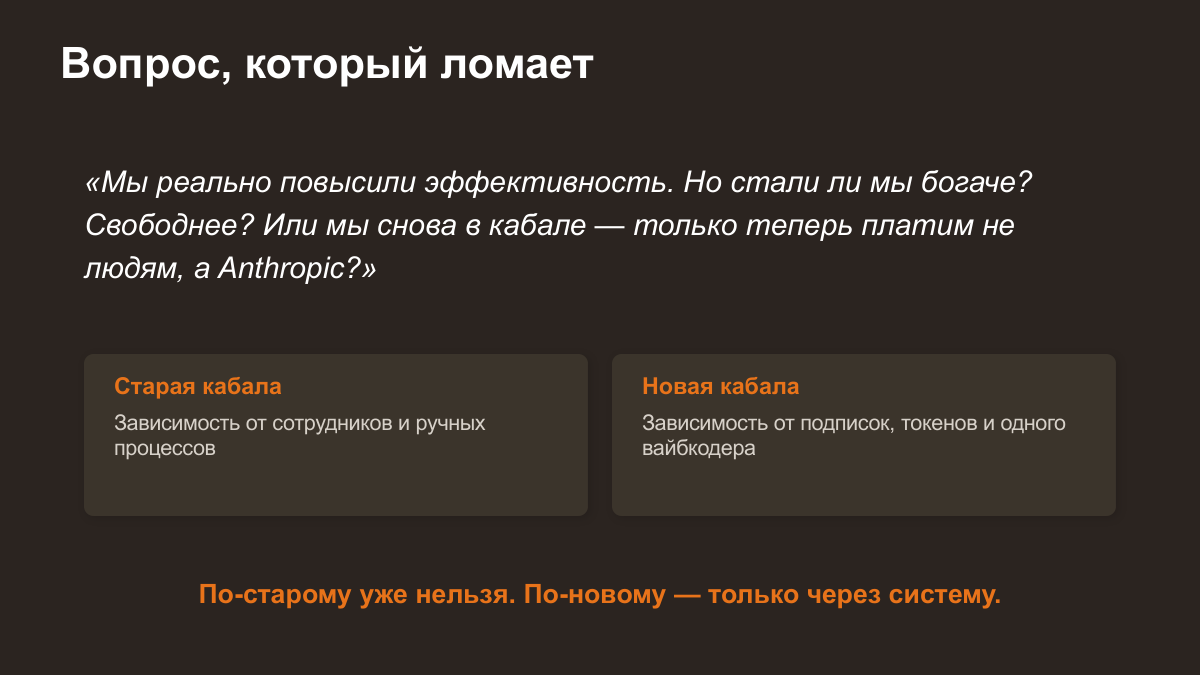
Возвращаемся к вопросу, с которого всё началось: «Мы реально повысили эффективность. Но стали ли мы богаче? Свободнее? Или мы снова в кабале — только теперь платим не людям, а Anthropic?»
Старая кабала — зависимость от сотрудников и ручных процессов. Новая кабала — зависимость от подписок, токенов и одного вайбкодера.
При этом фарш уже провернули: по-старому работать нельзя, а по-новому реально умеют единицы. По-новому — только через систему.
Выход: как это сделали мы
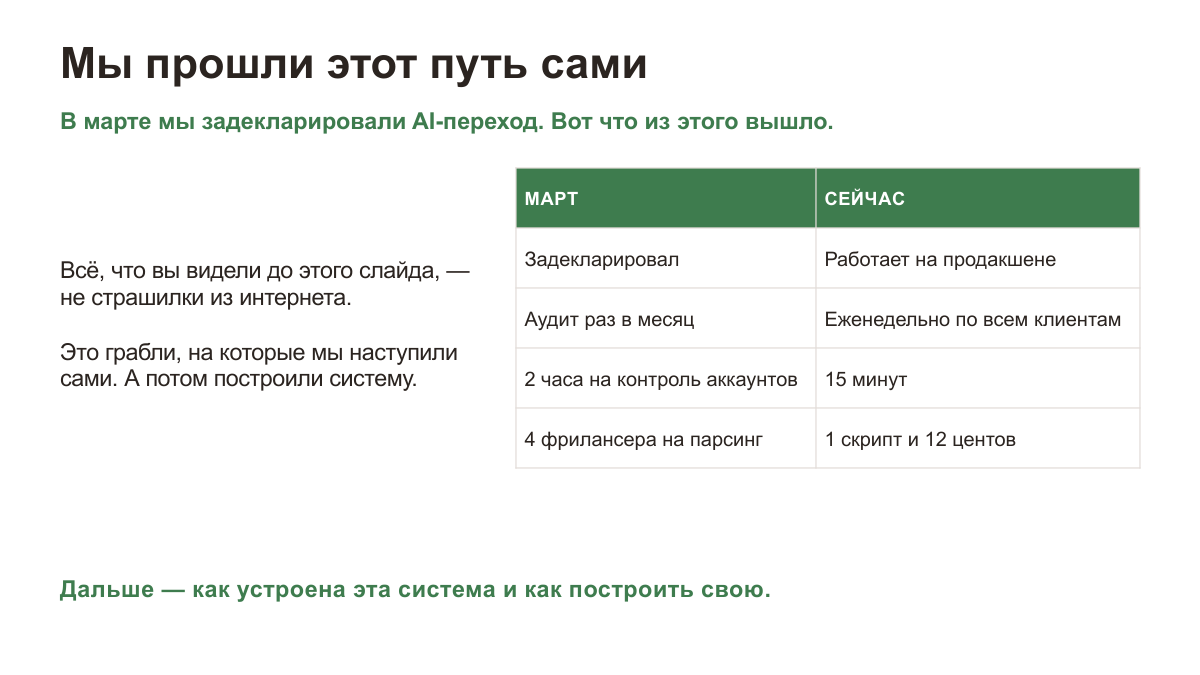 Слайд 18 — что изменилось с марта
Всё перечисленное выше — не страшилки из интернета, а грабли, на которые мы наступили сами, прежде чем построили систему.
| Март | Сейчас | |
|---|---|---|
| AI-переход | Задекларировал | Работает на продакшене |
| Аудит | Раз в месяц | Еженедельно по всем клиентам |
| Контроль аккаунтов | 2 часа | 15 минут |
| Парсинг | 4 фрилансера | 1 скрипт и 12 центов |
Почему получилось. К моменту перехода в команде уже была куча заготовок: коннекторы для Google Search Console, Яндекс.Метрики, Топвизора, Яндекс.Вордстата, KeySO, DataForSEO, парсеры, автоматизации для сервисов ссылок — GoGetLinks, Miralinks. Оставалось собрать это в единую систему.
Отдельно про реакцию команды. Были опасения, что сотрудники скажут «Влад опять напридумывал, а нам разгребать». Показательный случай: сотрудница ушла в декрет ещё до появления ChatGPT и вернулась через три года. Ей выдали папку со скиллами и два-три дня на освоение — реакция была восторженной: «Это то, чем я раньше занималась весь день, а сейчас делается на автомате».
Лифт без лифтёра
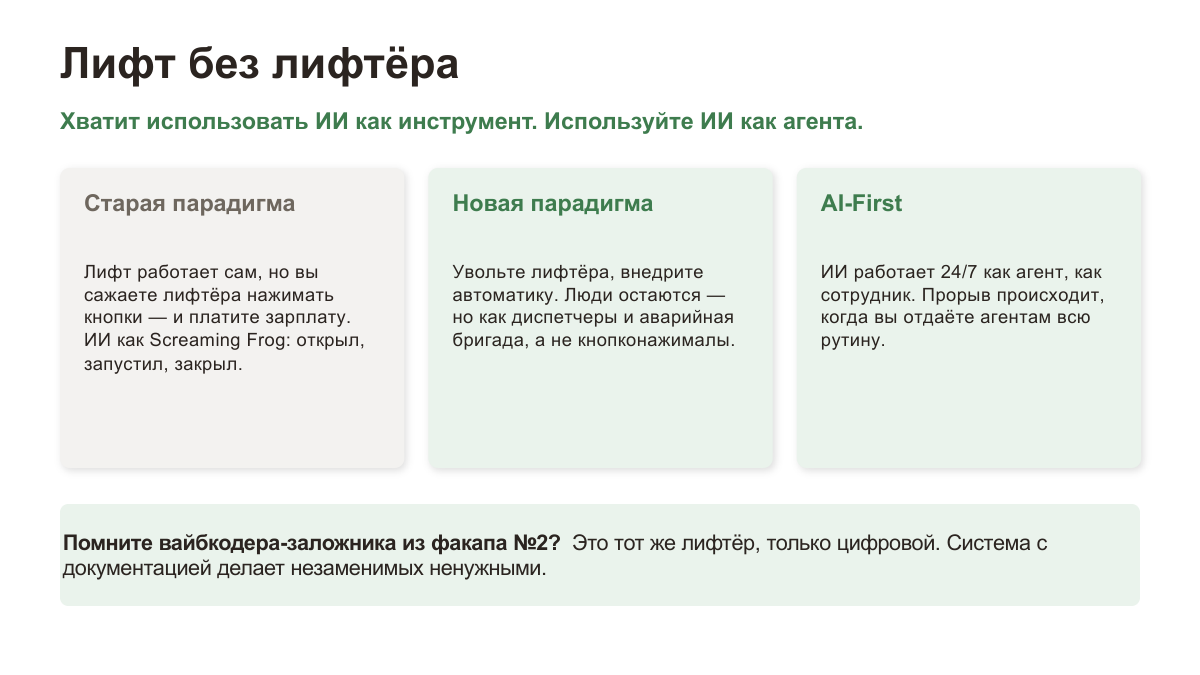 Слайд 19 — смена парадигмы
Старая парадигма. Лифт работает сам, но вы сажаете лифтёра нажимать кнопки и платите ему зарплату. ИИ используется как Screaming Frog: открыл, запустил, закрыл.
Новая парадигма. Увольте лифтёра, внедрите автоматику. Люди остаются — но как диспетчеры и аварийная бригада, а не кнопконажималы.
AI-first. ИИ работает 24/7 как агент, как сотрудник. Прорыв происходит, когда вы отдаёте агентам всю рутину.
Помните вайбкодера-заложника из факапа № 2? Это тот же лифтёр, только цифровой. Система с документацией делает незаменимых ненужными.
Именно здесь ключевая ошибка большинства команд: ИИ используют как инструмент. Захотелось — задали промпт, нажали кнопку, получили результат. Это старая парадигма. Тот же n8n — просто инструмент: генерируя на нём статьи, вы по-прежнему используете ИИ как сервис, а не как агента.
Как устроена система
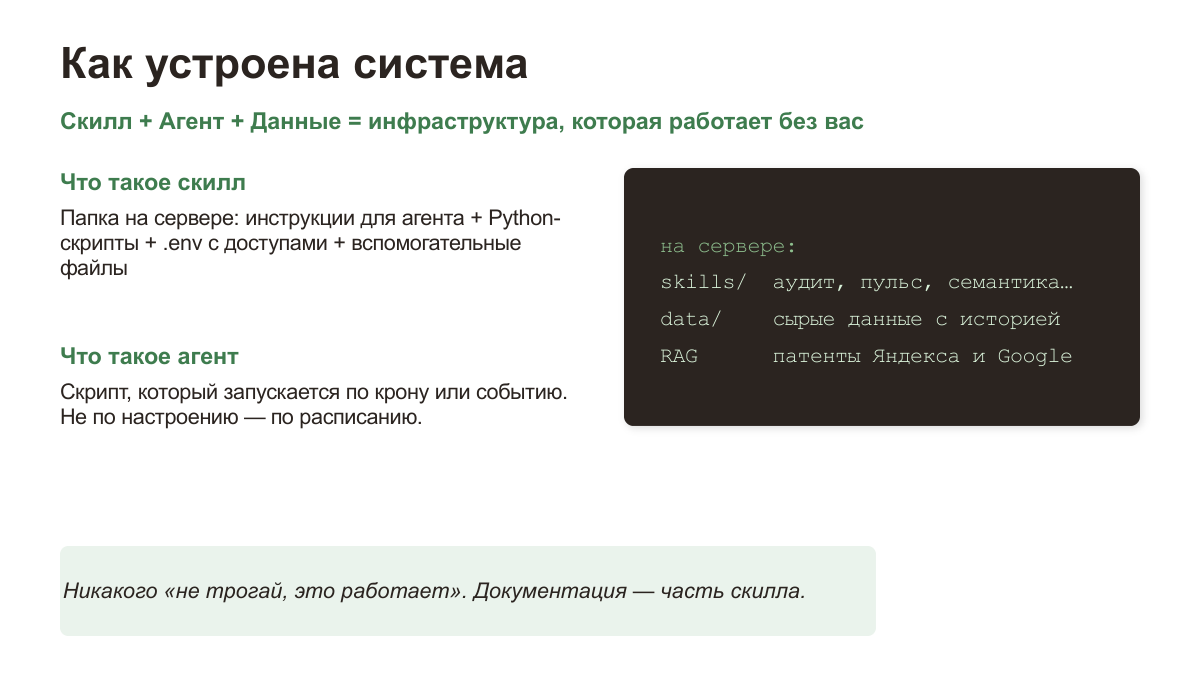 Слайд 21 — скилл + агент + данные
Скилл — папка на сервере: инструкции для агента, Python-скрипты, .env с доступами, вспомогательные файлы.
Агент — скрипт, который запускается по крону или по событию. Не по настроению, а по расписанию.
На сервере:
skills/   аудит, пульс, семантика…
data/     сырые данные с историей
RAG       патенты Яндекса и Google
Никакого «не трогай, это работает». Документация — часть скилла.
В боевой конфигурации агентства на сервере лежат папки: агенты, конфиги, дашборды, данные, knowledge base, скрипты, скиллы. Доступ к серверу есть у сотрудников.
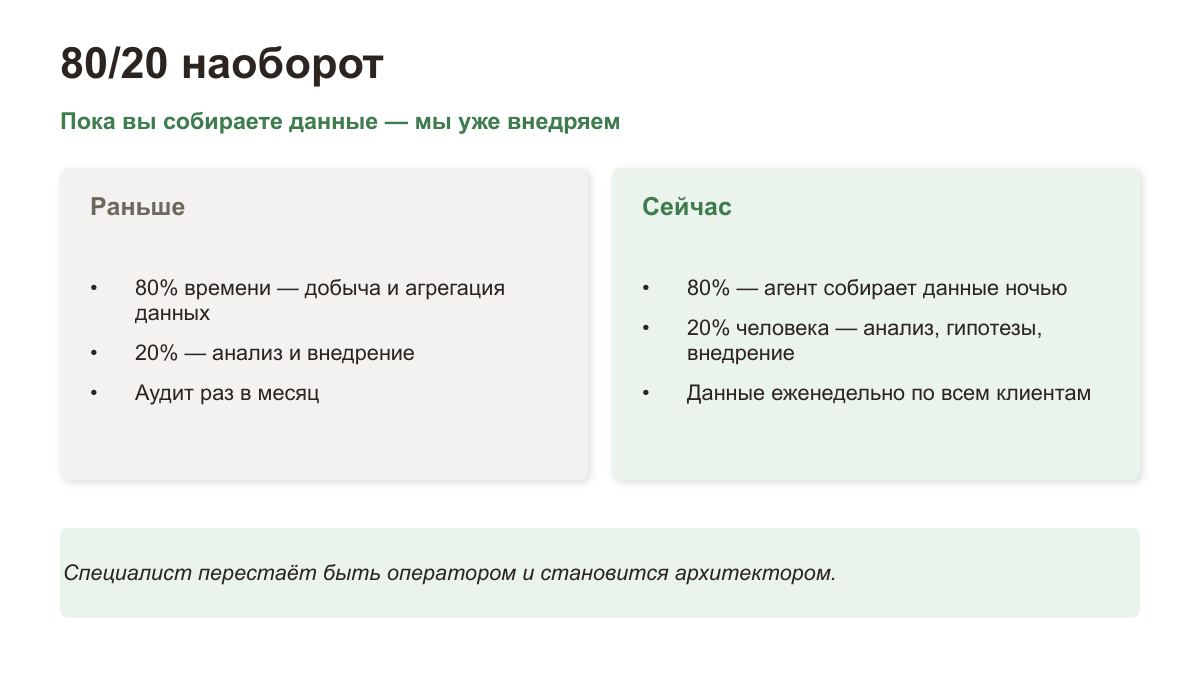 Слайд 22 — смена пропорции
Раньше: 80% времени — добыча и агрегация данных, 20% — анализ и внедрение, аудит раз в месяц.
Сейчас: 80% — агент собирает данные ночью, 20% времени человека — анализ, гипотезы, внедрение, данные еженедельно по всем клиентам.
Специалист перестаёт быть оператором и становится архитектором. Технический аудит руками не делается с апреля — это прямой запрет. Агент запускается по крону вечером, к утру отчёт готов по всем сайтам.
Меняется и структура ролей. Раньше для той же задачи требовались трое: джун, проставляющий галочки по чек-листу; специалист, сводящий данные; аналитик, рисующий роадмап. Теперь вместо джуна — скилл, вместо аналитика — Claude, а на выходе нужен мидл, который проверит гипотезы и отберёт рабочие. Роль мидлов и сеньоров со скиллами резко растёт, а обычные джуны с чек-листами оказываются не нужны.
Кейс 1. Account Pulse
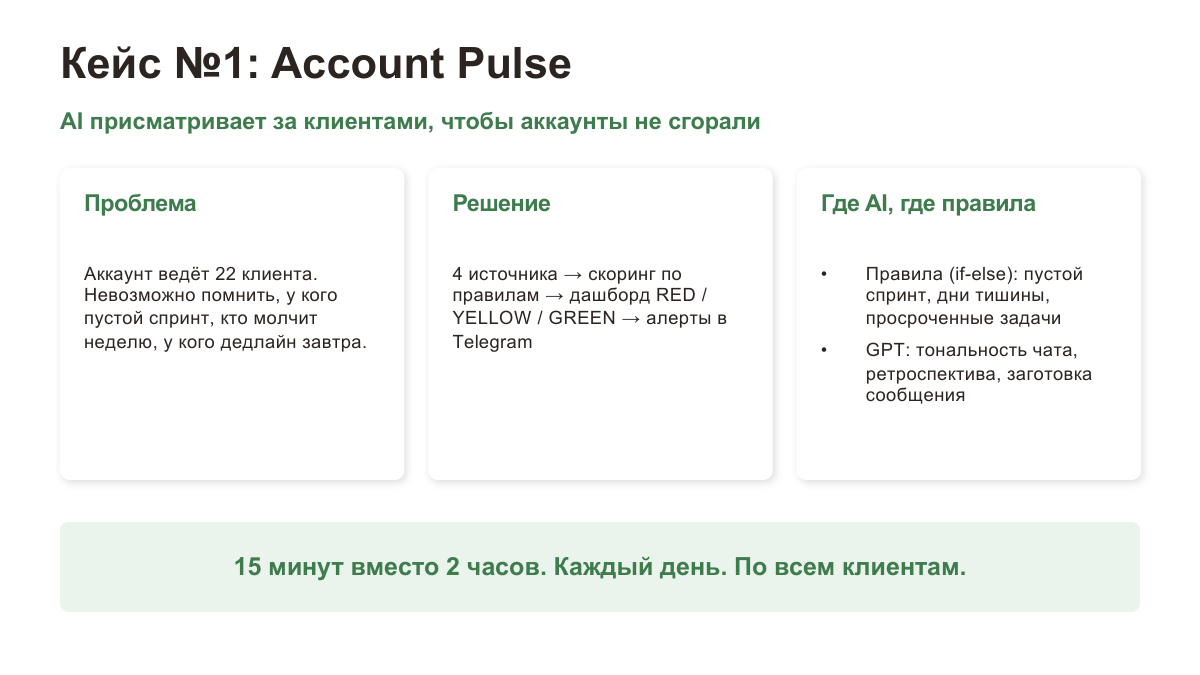 Слайд 23 — AI присматривает за клиентами
Проблема. Аккаунт ведёт 22 клиента. Невозможно помнить, у кого пустой спринт, кто молчит неделю, у кого дедлайн завтра.
Решение. Четыре источника → скоринг по правилам → дашборд RED / YELLOW / GREEN → алерты в Telegram.
Где правила, а где AI:
- Правила (if-else): пустой спринт, дни тишины, просроченные задачи.
- GPT: тональность чата, ретроспектива, заготовка сообщения.
Скилл ходит в Telegram-чаты и выгружает переписку, в CRM за задачами, в клиентские дашборды со спринтами. На выходе — дашборд с зонами риска по клиентам и сообщения в рабочий чат каждые несколько часов: сколько неотвеченных чатов, сколько незакрытых задач, где не подгружены задачи в клиентский дашборд.
Эффект: 15 минут вместо 2 часов, каждый день, по всем клиентам. Раньше последняя неделя месяца уходила на разгребание хвостов. Как сформулировала сотрудница: «Раньше горело в конце месяца — теперь горит каждую неделю», потому что к пятнице всё должно быть закрыто.
Кейс 2. Технический аудит
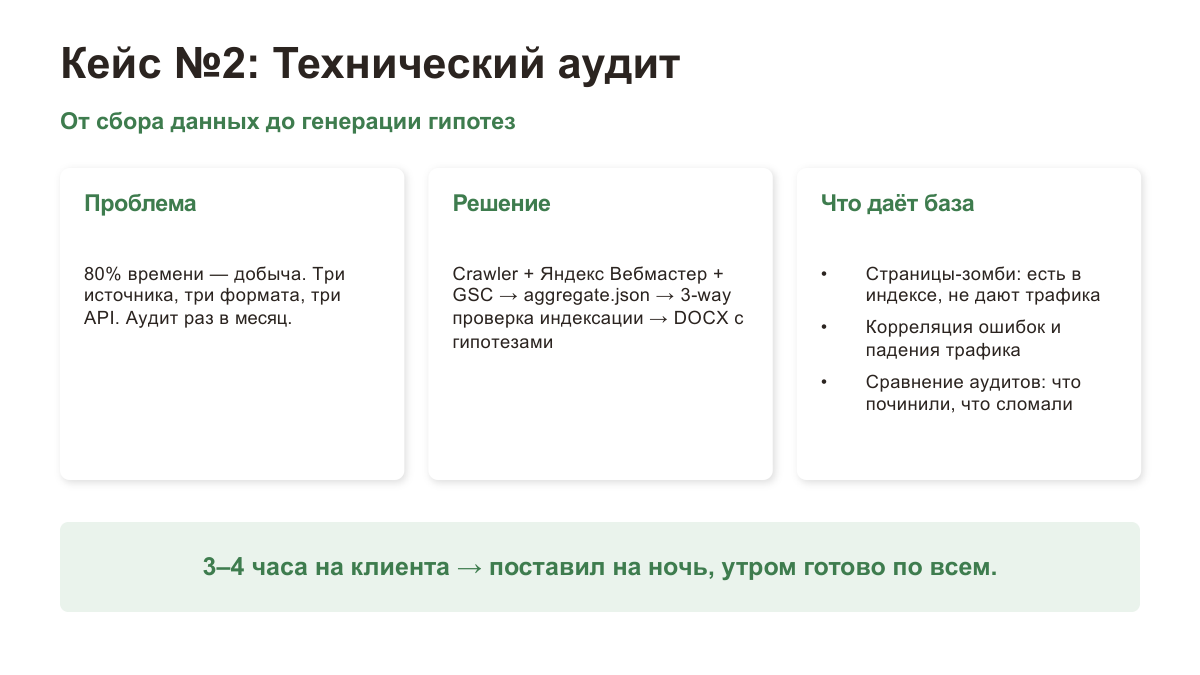 Слайд 24 — от сбора данных до генерации гипотез
Проблема. 80% времени — добыча. Три источника, три формата, три API. Аудит раз в месяц.
Решение. Crawler + Яндекс.Вебмастер + GSC → aggregate.json → трёхсторонняя проверка индексации → DOCX с гипотезами.
Что даёт накопленная база:
- страницы-зомби: есть в индексе, но не дают трафика;
- корреляция ошибок и падения трафика;
- сравнение аудитов между собой: что починили, а что сломали.
Эффект: было 3–4 часа на клиента, стало — поставил на ночь, утром готово по всем.
Родственный скилл — поиск слабых страниц. На вход доменное имя, на выходе Markdown и PDF с таблицей мероприятий. Внутри: чтение паспорта проекта, загрузка семантики, позиций и метрик (данные уже собраны, руками в Вебмастер никто не ходит), отбор слабых страниц, краулинг конкурентов и сверка с базой патентов Google и Яндекса. Всё это уходит в Claude с задачей подготовить мероприятия по улучшению страниц.
Отдельный скилл для медицинской тематики работает по чек-листу, собранному из патентов и Schema.org: скрипт с эмуляцией браузера обходит сайт клиники, вытаскивает контент и микроразметку, чек-лист в Markdown уходит в модель — и на выходе постраничный разбор: фото врача есть, показания есть, противопоказаний нет, сертификаты не указаны, блок «как подготовиться» отсутствует. Раньше сотрудник заполнял эти галочки руками по каждой странице; сейчас крупная клиника обходится за час-два.
Дальше к этой таблице добавляются SEO-параметры — title, заголовки, вхождения, частотность по кластеру — и из сотни страниц отбираются десять с максимальным потенциалом роста, которые и берутся в работу.
Кейс 3. Парсер ЖК
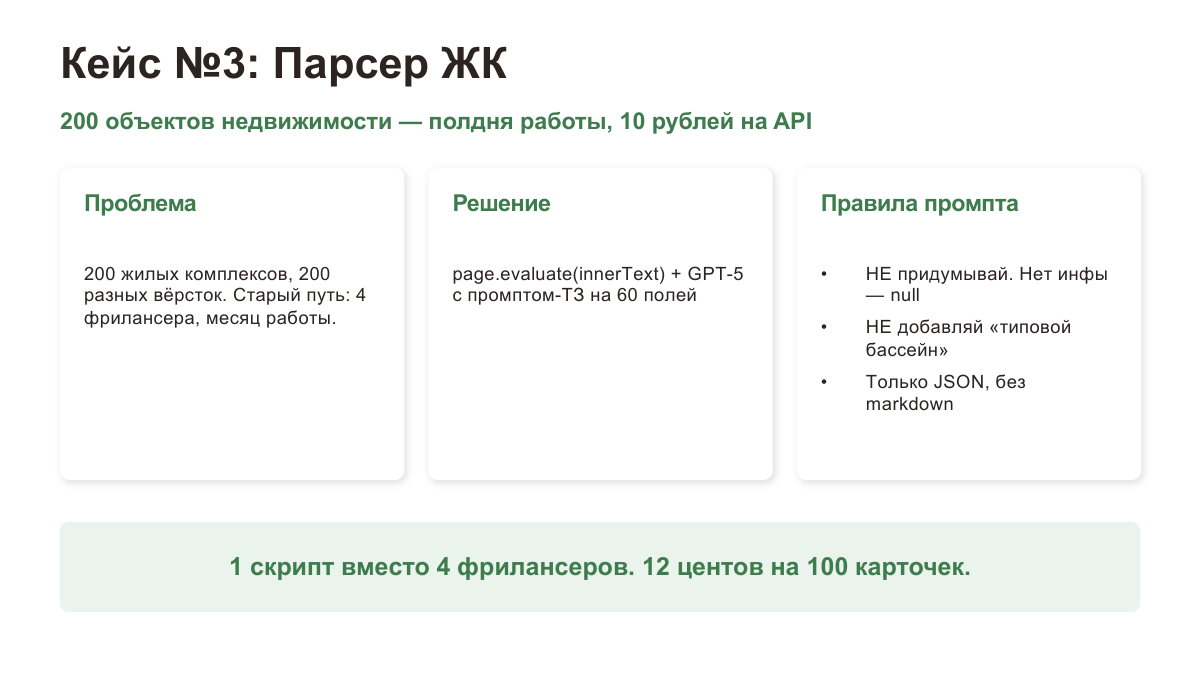 Слайд 25 — 200 объектов недвижимости
Проблема. 200 жилых комплексов, 200 разных вёрсток. Старый путь — четыре фрилансера и месяц работы.
Решение. page.evaluate(innerText) + GPT-5 с промптом-ТЗ на 60 полей.
Правила промпта:
- НЕ придумывай. Нет информации —
null. - НЕ добавляй «типовой бассейн».
- Только JSON, без markdown.
Результат: один скрипт вместо четырёх фрилансеров, 12 центов на 100 карточек.
Как построить систему
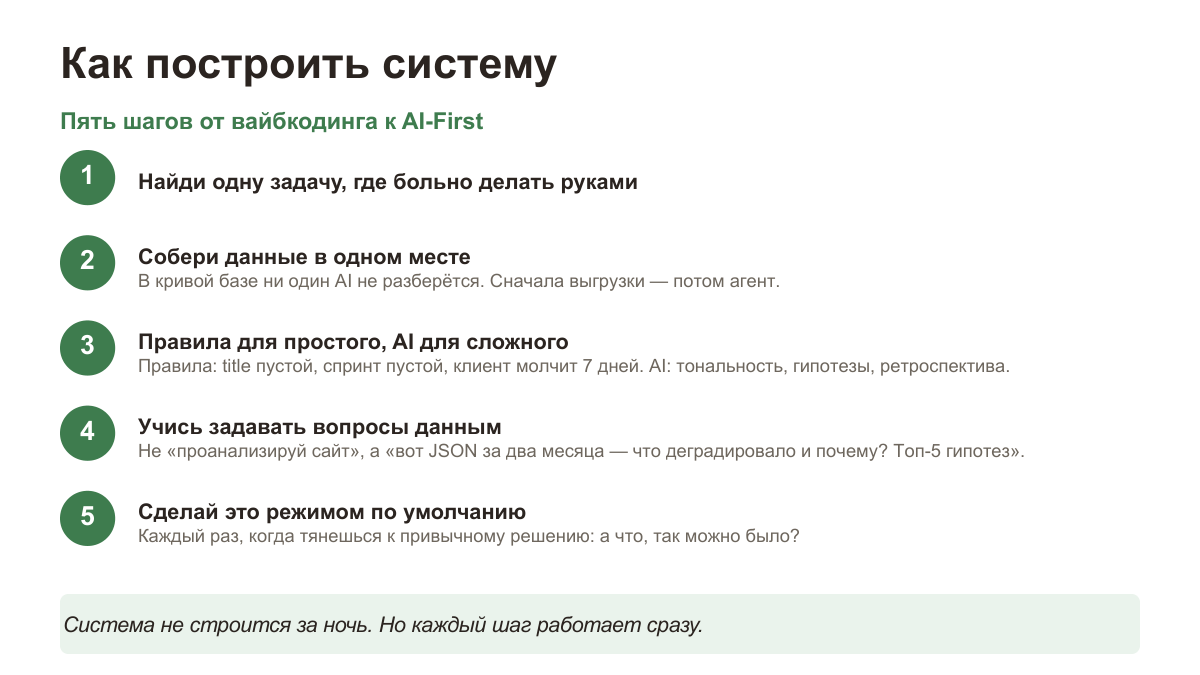 Слайд 26 — от вайбкодинга к AI-first
1. Найди одну задачу, где больно делать руками.
2. Собери данные в одном месте. В кривой базе ни один AI не разберётся. Сначала выгрузки — потом агент.
3. Правила для простого, AI для сложного. Правила: title пустой, спринт пустой, клиент молчит 7 дней. AI: тональность, гипотезы, ретроспектива.
4. Учись задавать вопросы данным. Не «проанализируй сайт», а «вот JSON за два месяца — что деградировало и почему? Топ-5 гипотез».
5. Сделай это режимом по умолчанию. Каждый раз, когда тянешься к привычному решению: а что, так можно было?
Система не строится за ночь, но каждый шаг работает сразу.
Три практических предостережения
С нуля систему не построить. Нужно хотя бы базово понимать программирование. Либо закрыться с думающей моделью и сначала спроектировать архитектуру. Программиста имеет смысл привлечь хотя бы на уровень архитектуры.
Не уходите в тяжёлую инфраструктуру. Типичная ошибка: подключается программист и предлагает поднять MongoDB или PostgreSQL, складывать всё туда и оттуда выгружать. Итог — без программиста система не работает. У нас всё собрано намеренно просто: выгрузки в Excel, CSV и JSON. Потому что в любой такой файл рядовой сотрудник может просто провалиться и посмотреть глазами — зайти в папку с выгрузками Search Console, выбрать дату, открыть файл. Никаких запросов в базу и отваливающихся панелей.
Начинайте от самой частой задачи. Мы выгрузили из CRM все задачи за последние полгода, посчитали повторяемость и автоматизировали самые частотные. Идите от того, что напрягает больше всего.
Итог
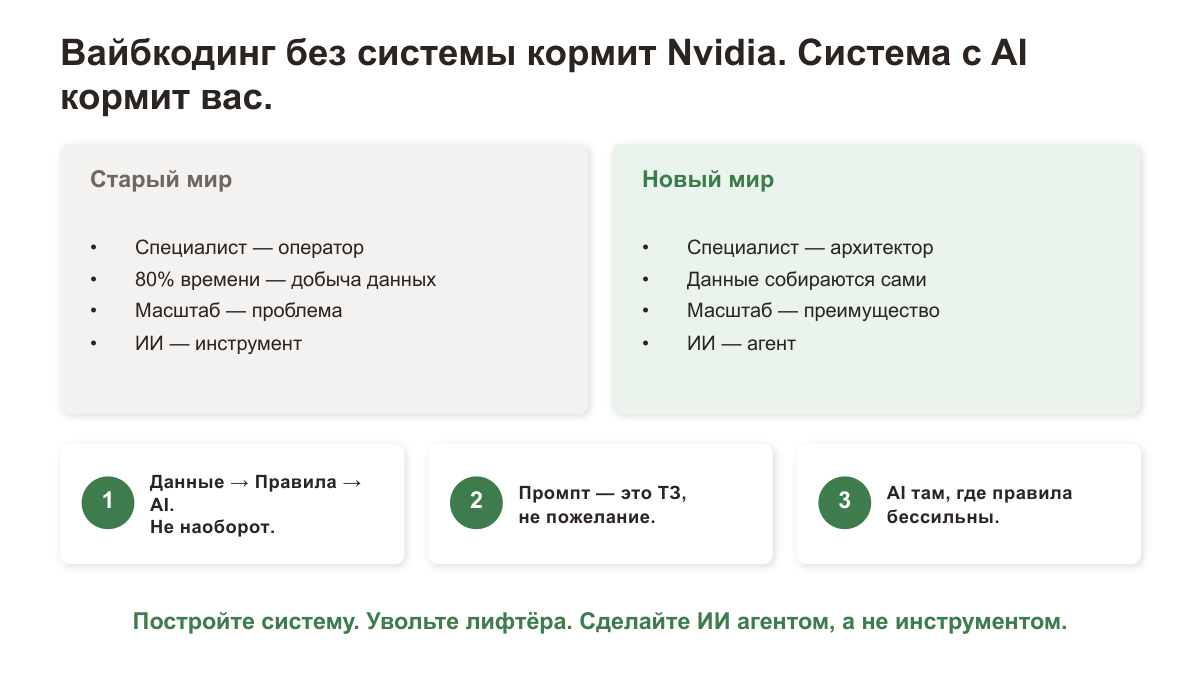 Слайд 27 — вайбкодинг без системы кормит Nvidia
| Старый мир | Новый мир |
|---|---|
| Специалист — оператор | Специалист — архитектор |
| 80% времени — добыча данных | Данные собираются сами |
| Масштаб — проблема | Масштаб — преимущество |
| ИИ — инструмент | ИИ — агент |
Три правила:
- Данные → Правила → AI. Не наоборот.
- Промпт — это ТЗ, а не пожелание.
- AI там, где правила бессильны.
Отдельно про экономию. Есть знакомые, которые хвастаются: «за ночь сожгли 200 долларов лимитов». Это забивание гвоздей микроскопом. Если нужно спарсить сайт — есть Screaming Frog, есть A-Parser, можно написать парсер на Python и запускать по крону. Дорогую модель подключайте в конце, как мозг.
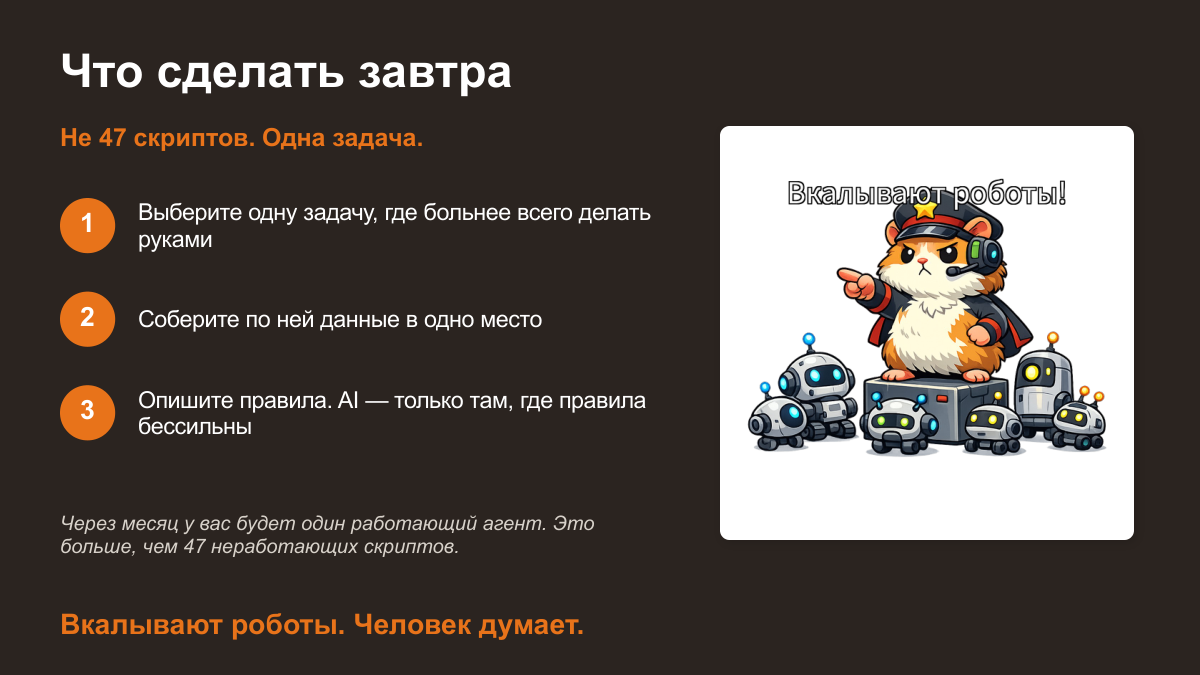 Слайд 28 — не 47 скриптов, а одна задача
- Выберите одну задачу, где больнее всего делать руками.
- Соберите по ней данные в одно место.
- Опишите правила. AI — только там, где правила бессильны.
Через месяц у вас будет один работающий агент. Это больше, чем 47 неработающих скриптов.
Постройте систему. Увольте лифтёра. Сделайте ИИ агентом, а не инструментом.
Ответы на вопросы
Как за 30 секунд понять, что сеошника уже побрили? Какой первый красный флаг?
Попросить показать, как всё организовано. Если у него только промпты — нулевой уровень. Если есть скилл — уже второй уровень. Если внутри скилла грамотная оркестрация — поднимите ему зарплату и пожмите руку.
Оркестрация — это когда задача разбита на этапы и каждый этап выполняется самым дешёвым подходящим способом. Пример с парсингом ЖК: URL застройщиков снимаются скриптом через XML River, страницы парсятся бесплатным парсером на Python, оттуда вытаскиваются title и h1, проверяется наличие маркеров вроде «официально от застройщика» — и только структурированный результат уходит в GPT для финального разбора. Мы не просим дорогую модель «зайти и найти выдачу».
Второй пример — пайплайн подготовки аутлайна для статьи, где участвуют пять моделей: кластер запросов уходит в поиск через XML River (копейки), конкуренты парсятся бесплатно, тексты прогоняются через Google NLP для извлечения сущностей, затем Knowledge Graph, затем суммаризация недорогой моделью, и только финальное ТЗ и написание статьи отдаются Claude Sonnet — самой дорогой модели в цепочке, включающейся последней.
Какой самый опасный неочевидный побочный эффект генеративного ИИ для SEO?
Эффект подмены. ИИ — это большой мультипликатор (формулировка не моя, её приписывают Оскару Хартманну). Если взять скиллы сильного специалиста и добавить ИИ — получится ×10. Если взять неграмотного специалиста и умножить на ту же десятку — получится −10. Опасность в том, что вы умножаете то, что есть: если внутри бардак и хаос, вы увеличиваете бардак в десять раз.
Как боретесь с галлюцинациями без ручной проверки каждого абзаца?
Во-первых, написание контента полностью ИИ не доверено — этим занимается контент-редактор. Во-вторых, работает жёсткое ТЗ: обычно это документ на 500–1000 строк, куда добавляются редакционная политика и маркетинг-кит клиента — что говорить, чего не говорить, какие УТП.
В-третьих, текст прогоняется через фактчекинг в нескольких моделях. Единого источника истины, куда можно отправить текст по API и получить проверку, сейчас нет. У нас фактчекинг-скилл построен на Perplexity Sonar Pro с проверкой по базе SEO-патентов.
Общее правило: чем больше структурированных данных вы отдаёте модели, тем меньше она галлюцинирует. Около 90% всей работы делает Python, а он галлюцинациями не страдает. Если скрипту сказано зайти на страницу и вытащить title, h1 или количество товаров в листинге по XPath — он именно это и сделает.
Как технически собрать ответы разных нейросетей и сравнить их?
Пайплайн собрать можно, но готового удобного решения под рукой нет — у нас это реализовано в виде скилла с проверкой через Perplexity и сверкой с патентами.
Мы переехали на свою вайбкоженную SEO CRM на WordPress, есть явная выгода. Как относитесь?
Решение может быть отличным, вопрос в зависимости. Что будет, если автор этой системы найдёт более денежную работу и всё забросит? Без него система, скорее всего, встанет. В нашем случае привязки к платформе нет: обычные файлы и скиллы, а скилл — это уже фактически стандарт.
Техничка от нейросетей генерирует бредятину каждый второй раз. Что делать?
См. выше: отдавайте максимум работы детерминированному коду, а модели — структурированные данные. Чем больше простора для фантазии вы оставляете, тем хуже результат.
Про выбор модели и стоимость
Мы перешли с Claude на Kimi — по сути тот же формат работы, но дешевле, и главное, без банов российских аккаунтов. Игра в кошки-мышки с блокировками отнимала слишком много нервов: несколько заблокированных аккаунтов, попытки работать через посредников, отваливающиеся интеграции.
По ощущениям Kimi медленнее процентов на 20–30. За первый месяц работы всей командой израсходовано менее половины лимитов на тарифе около $40. Неожиданно хорошо генерирует изображения — вся графика этой презентации сделана в нём.
При этом тексты пишутся только через Claude Sonnet, и доступ к нему идёт через Cursor: во-первых, так не прилетает бан, во-вторых, Cursor сжимает контекст — по оценке, экономия около 40% токенов без потери качества.
Про пузырь
Ощущение, что это пузырь, меня не покидает. Прямая ассоциация с криптовалютой 2018–2019 годов: то же нагнетание через все соцсети, те же истории про заработанные за ночь миллионы, тот же FOMO. Мимо тебя едет денежный поезд — вопрос в том, куда он едет. Он едет в офисы Nvidia.
Мы стали очень энергично и эффективно перебирать лапками. Но колесо осталось тем же.
Про экспертизу: новичок и профессионал получают от нейросетей разный результат
Всё так. Сильные специалисты — те, кто берёт документацию, сливы и патенты, загружает в думающую модель и неделями её допрашивает. Раньше прочитать этот объём было физически невозможно, сейчас — реально. У нас, например, развёрнута база на 2939 патентов Google и Яндекса, которая используется в скиллах как источник проверки гипотез.
Раньше эксперт мог десятилетие эксплуатировать формулу из своего блокнота. Эти времена прошли: данных в открытом доступе много, аналитический аппарат доступен каждому. Кто ищет — тот найдёт.
Материалы: видео · презентация
Автор: Владислав Папернюк, агентство «Сайт-Активатор» · телеграм-канал Python SEO 2 нейрона